
(1)无状态:一切的起点
写在前面
我第一次直接调 LLM API 的时候,被一个东西绊了一下:想实现多轮对话,居然要自己维护一个 messages 数组,每轮把历史全部传进去。
当时觉得这是 API 设计得糙。后来才明白,这不是设计的偷懒,是模型的本质:LLM 是无状态的。它不记得你,每一次调用,都是第一次见面。
这个系列第 0 篇说过,Agent 领域的所有痛点追到根上,是模型的两个先天事实。这篇讲第一个:无状态,以及它直接派生出来的三个概念。
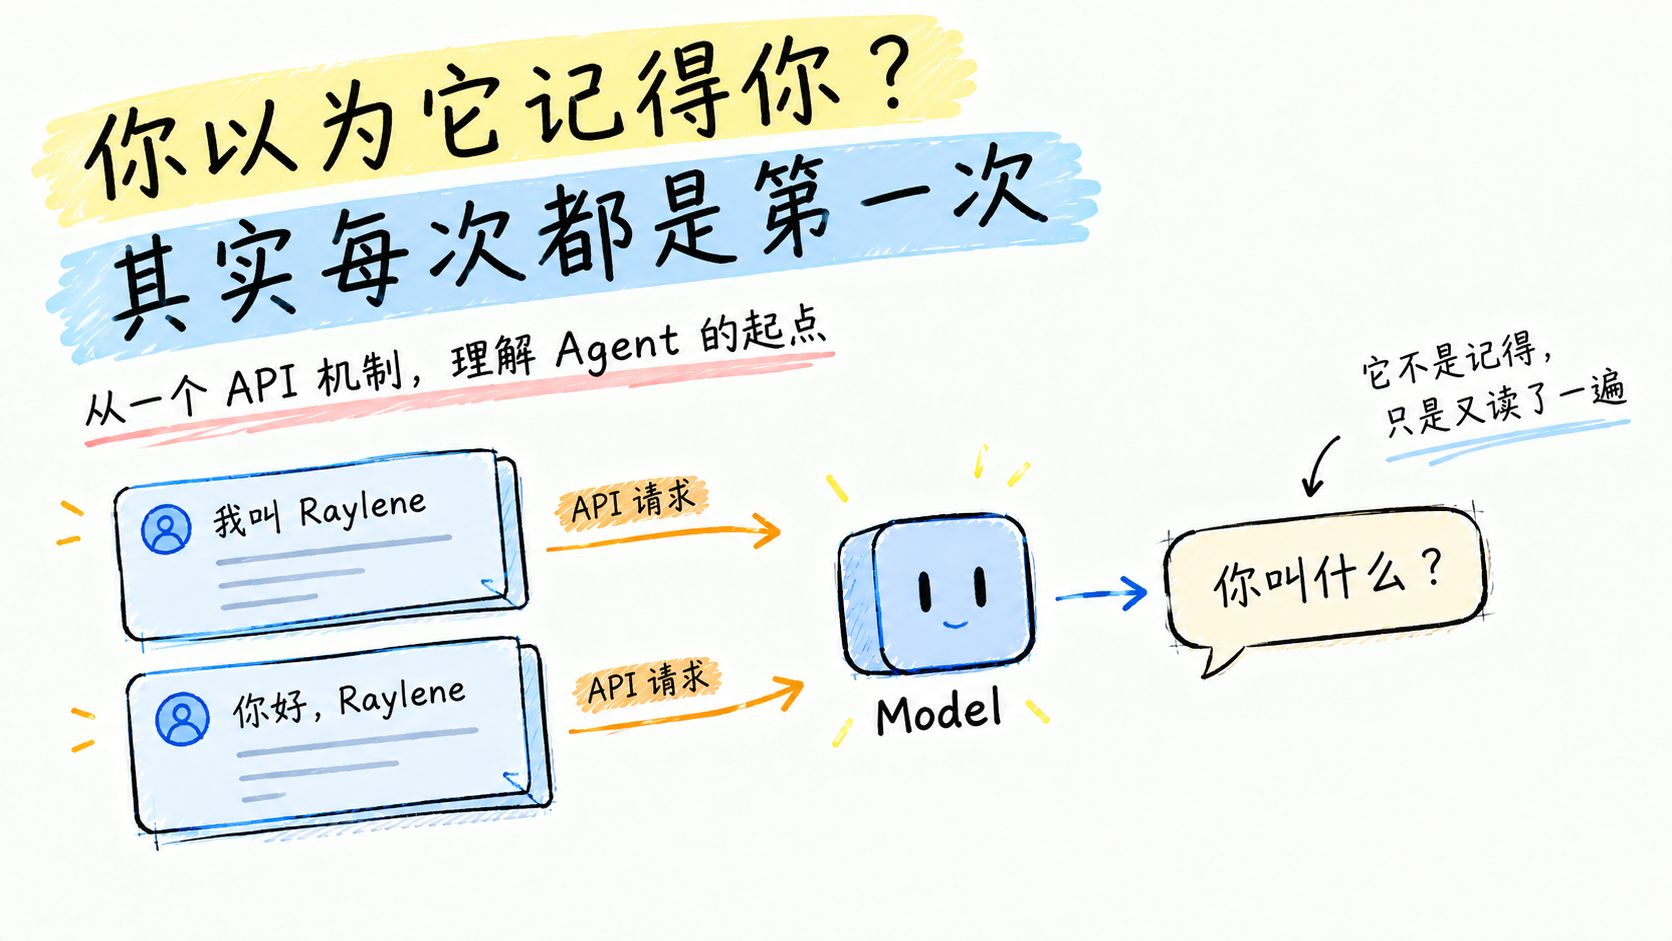
对话的连续性是假象
先看机制。调用聊天接口时,你的每一次请求都要带上完整的对话历史:
resp = client.chat.completions.create(
    model="glm-5.3",
    messages=[
        {"role": "user", "content": "我叫 Raylene"},
        {"role": "assistant", "content": "你好,Raylene"},
        {"role": "user", "content": "我叫什么?"},
    ],
)
模型之所以"记得"你叫 Raylene,不是因为它记得,是因为你把前面两句原封不动又发了一遍。所谓对话记忆,是每次当场重读的输入。
在网页版 ChatGPT 里这个机制是藏起来的,看起来像模型记得一切。一旦你直接调 API,或者用本地客户端,假象就露馅了。拿第 0 篇介绍过的 pi 举例:它的会话就是本地一个 append-only 的 JSONL 文件,每轮对话追加一条记录,每次调用模型时,把当前分支的全部内容重新发一遍。文件就是"记忆",模型本身什么都没存。
IMPORTANT: 模型无状态,"记忆"只是当场重读的输入。这不是缺陷说明里的一行小字,它是后面一半 Agent 概念的因果起点。
你发的每句话都在按 token 计费
无状态的直接后果:对话要连续,就得每次重发全部历史,而 API 按 token 计费。
有人对 Claude Code 的一次真实调用做过拆解:用户输入"fix the login bug"只有 10 个 token 左右,但实际发出去的请求里,系统提示词约 15000 token,项目说明(CLAUDE.md)约 2000,记忆约 500,会话历史约 5000。你以为发了一句话,其实发了一封两万 token 的长信。
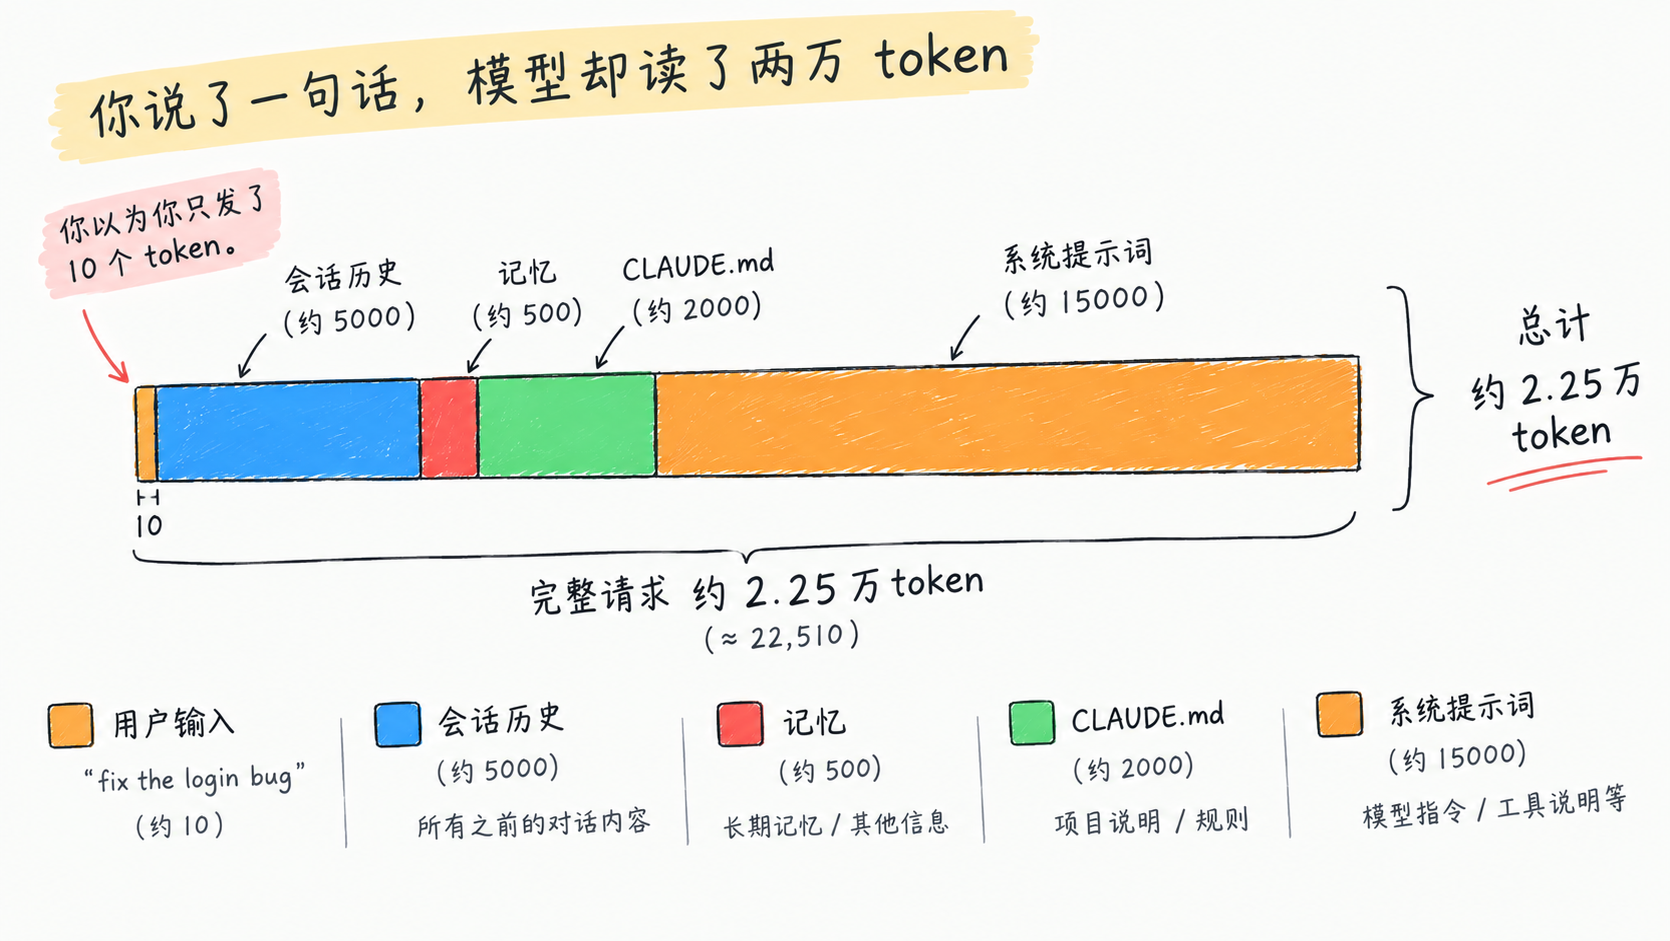
单轮对话还好,轮数一多,账单是平方级增长的:第 N 轮要付前 N-1 轮全部历史的钱。Agent 的场景更糟,工具的执行结果也要塞进历史,一条搜索结果的输出比你说的话长得多。
所以 Agent 领域对成本的敏感,远超普通聊天应用。这不是厂商贪婪,是无状态把"记住你说的话"变成了一个每次都要付费的动作。
窗口有限,且装得下不等于用得好
历史不能无限重发,因为有个硬顶:上下文窗口,模型单次能"看到"的 token 上限。
窗口这几年涨得很快,从早期的 4K 涨到现在的百万级。看起来问题在缓解,但 2023 年的一篇论文泼了冷水:往上下文中间放关键信息,模型的召回率显著下降,形成一个 U 型曲线,开头和结尾记得住,中间大面积遗忘。这就是 Lost in the Middle。
这个发现的含义比"窗口还不够大"严重。它说明单纯堆窗口不是出路:哪怕窗口有一百万,塞进去一百万,中间的部分模型也未必在用。装得下,不等于用得好。
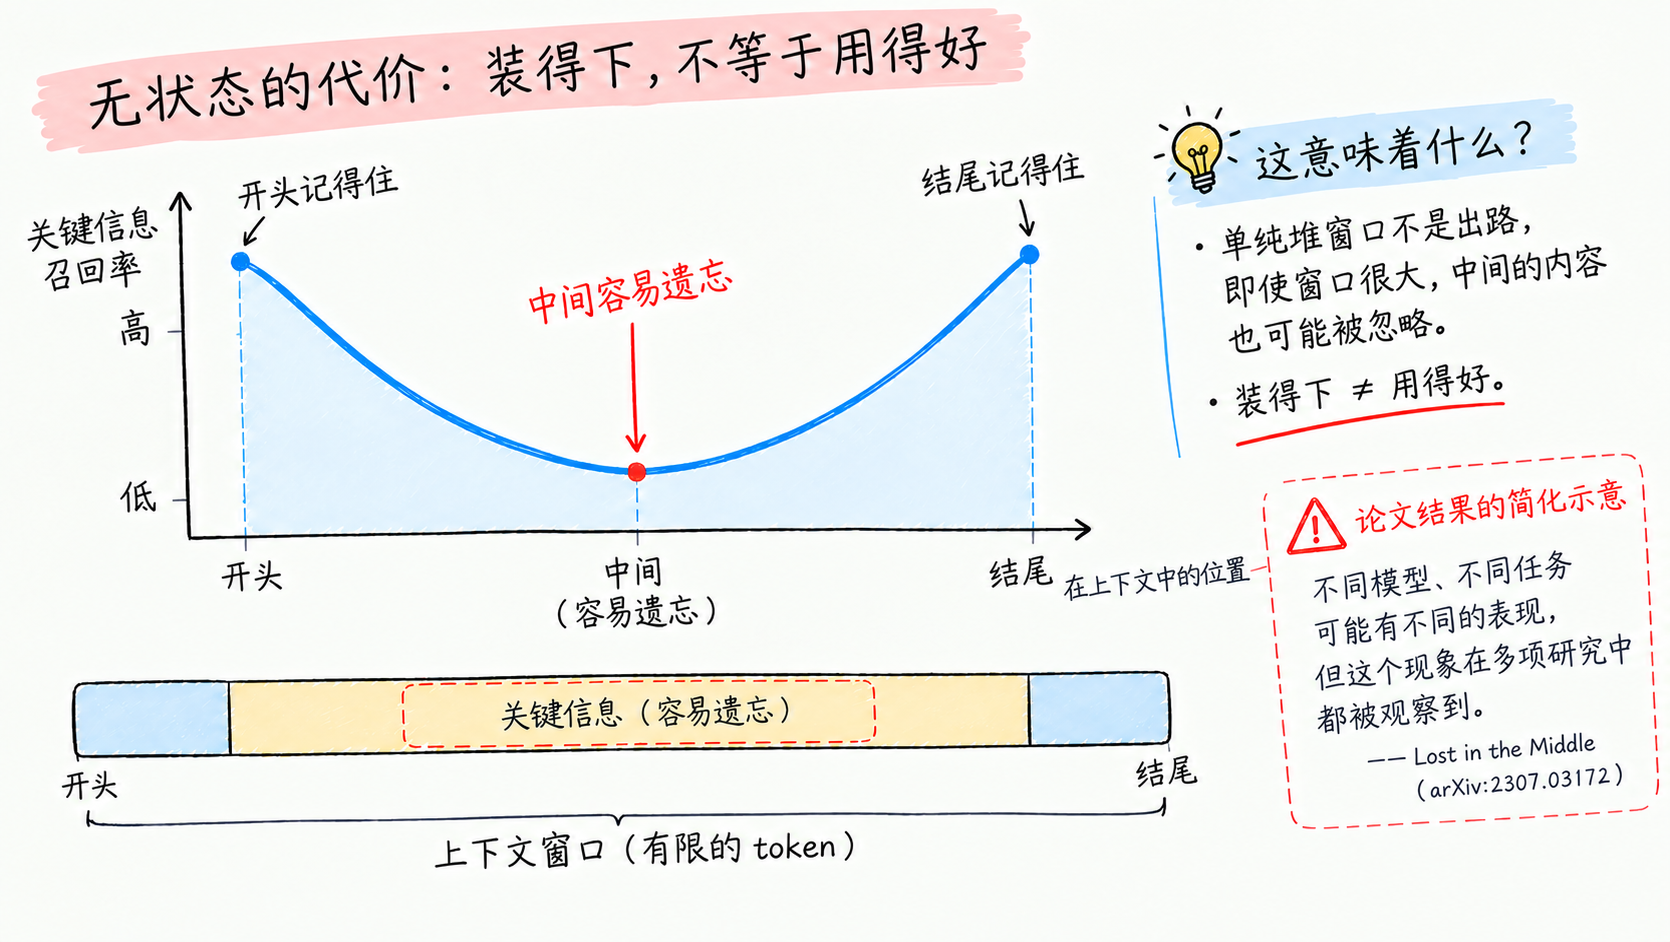
WARNING: "长上下文模型"和"模型能用好长上下文"是两件事。前者是参数量,后者是注意力分配。很多"窗口焦虑"其实是后者。
厂商的补救:把重复变便宜
面对成本问题,厂商的第一反应不是改模型,是改计费:prompt caching。
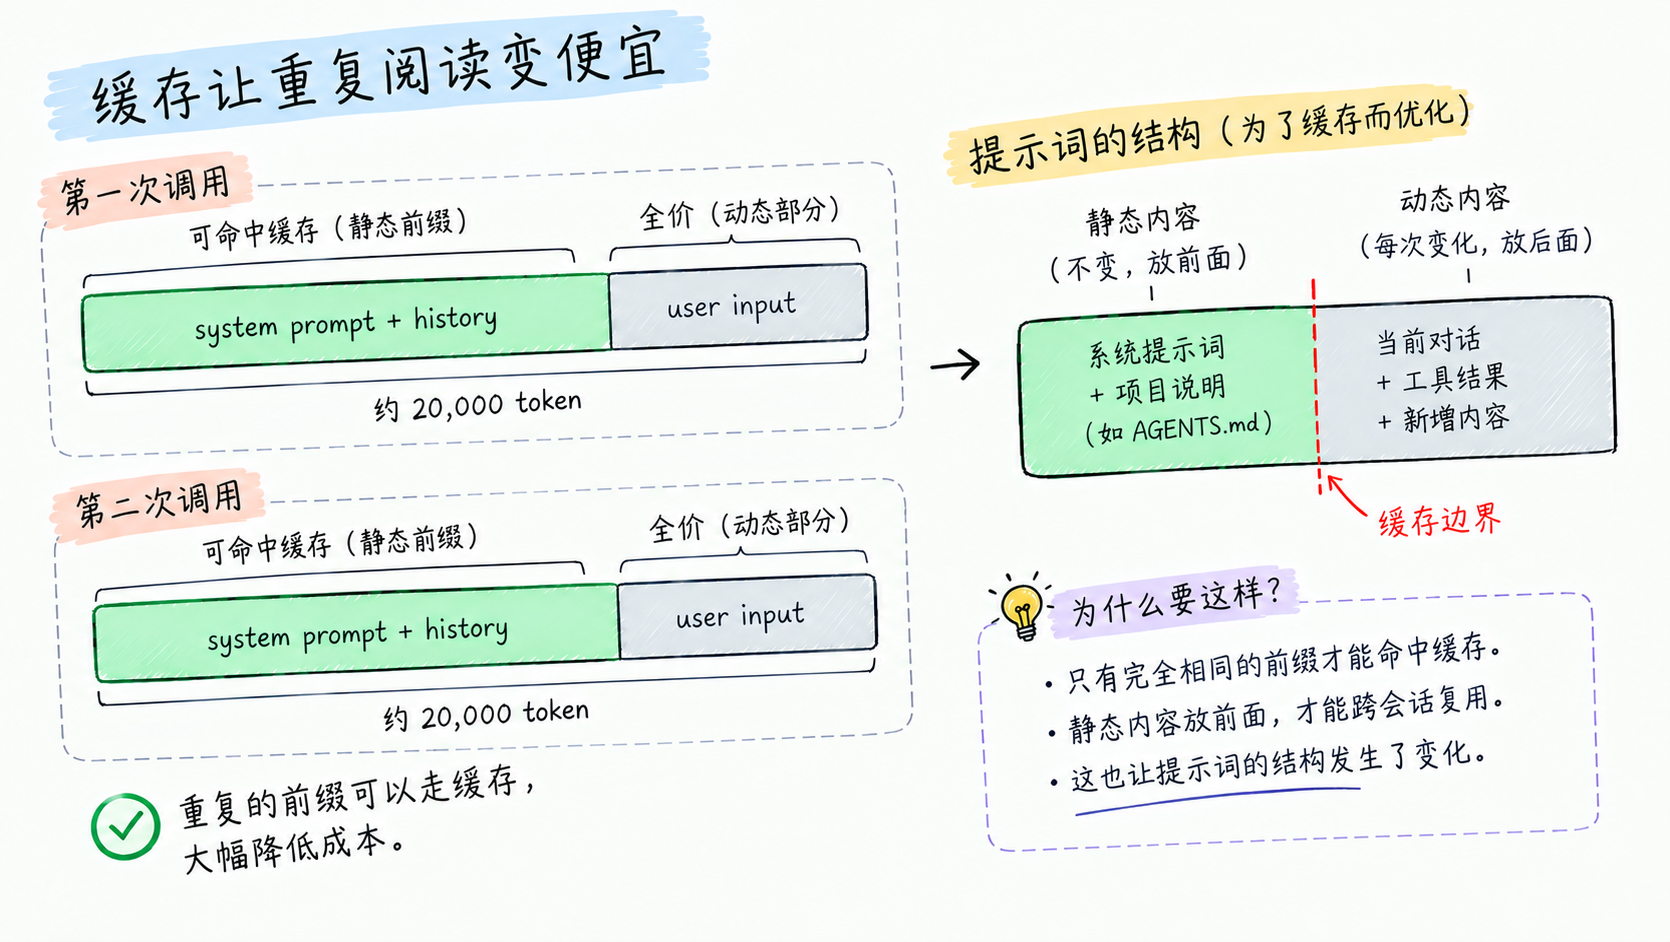
既然每次都要重发全部历史,而历史里绝大部分内容(系统提示词、早期对话)和上一次完全相同,那这部分重复前缀的推理就可以跳过,命中缓存的部分价格大幅下降。各厂商的具体比例不同,但方向一致:重复的部分变便宜了。
这个机制反过来影响了 harness 的设计。既然只有"完全相同的前缀"才能命中缓存,那系统提示词就值得拆成静态和动态两段,不变的内容放前面,易变的内容放后面。Claude Code 真的这么做了,在系统提示词里放了一个缓存边界标记,前面的内容跨会话共享缓存。为了省钱,提示词的结构都变了形。
一句话总结这一层:缓存把"重复读"变便宜了,但窗口的容量问题一点没解决。历史该涨还是涨,涨到窗口边缘,就得动刀。
写在最后
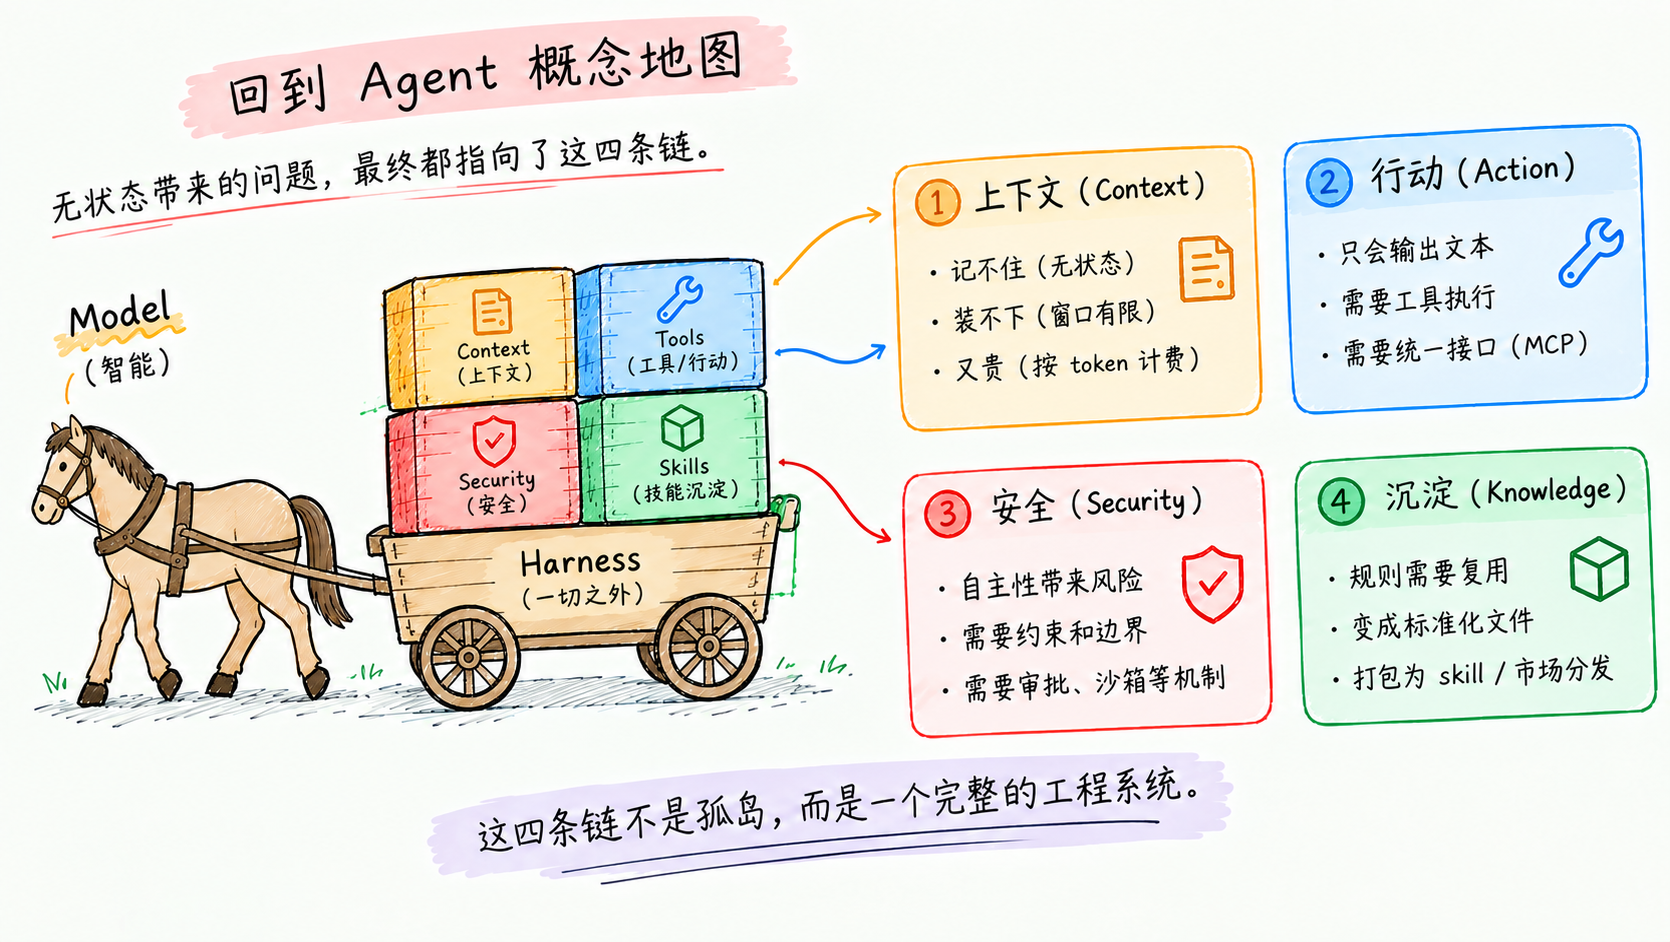
把这篇的因果线串起来:模型无状态,所以对话靠重发历史维持;重发按 token 计费,所以有了 prompt caching;重发受窗口硬顶限制,而且装得下不等于用得好。
上下文因此成了一种稀缺资源:又贵,又小。后面要讲的很多概念,compaction、RAG 之争、CLAUDE.md,都是在这两个约束下腾挪。
下一篇讲第一个腾挪手段:历史涨到窗口边上时,怎么把它压下去。也就是 compaction,压缩。
参考资料
- Lost in the Middle: Language Models Lose Context Mid-Document
- The Anatomy of Claude Code(token 拆解数字的出处)
- 本系列第 0 篇:(0)Agent 概念太多,先理清它们为什么出现