
(7)AutoGPT 之后:给自主性定价
写在前面
链二收尾时说过:行动的可靠性每一分提升,都在给下一篇文章交学费。链三讲的就是这笔学费。
上一篇的 subagent 让分身跑起来了,但分身一多,一个更根本的问题显形:模型的每一步都是自己决定的,它决定错了怎么办?效率的每一分提升,对应着失控规模的同比例放大。
这条链的起点是一次著名的公开失败。
AutoGPT:赌对了方向,付错了学费
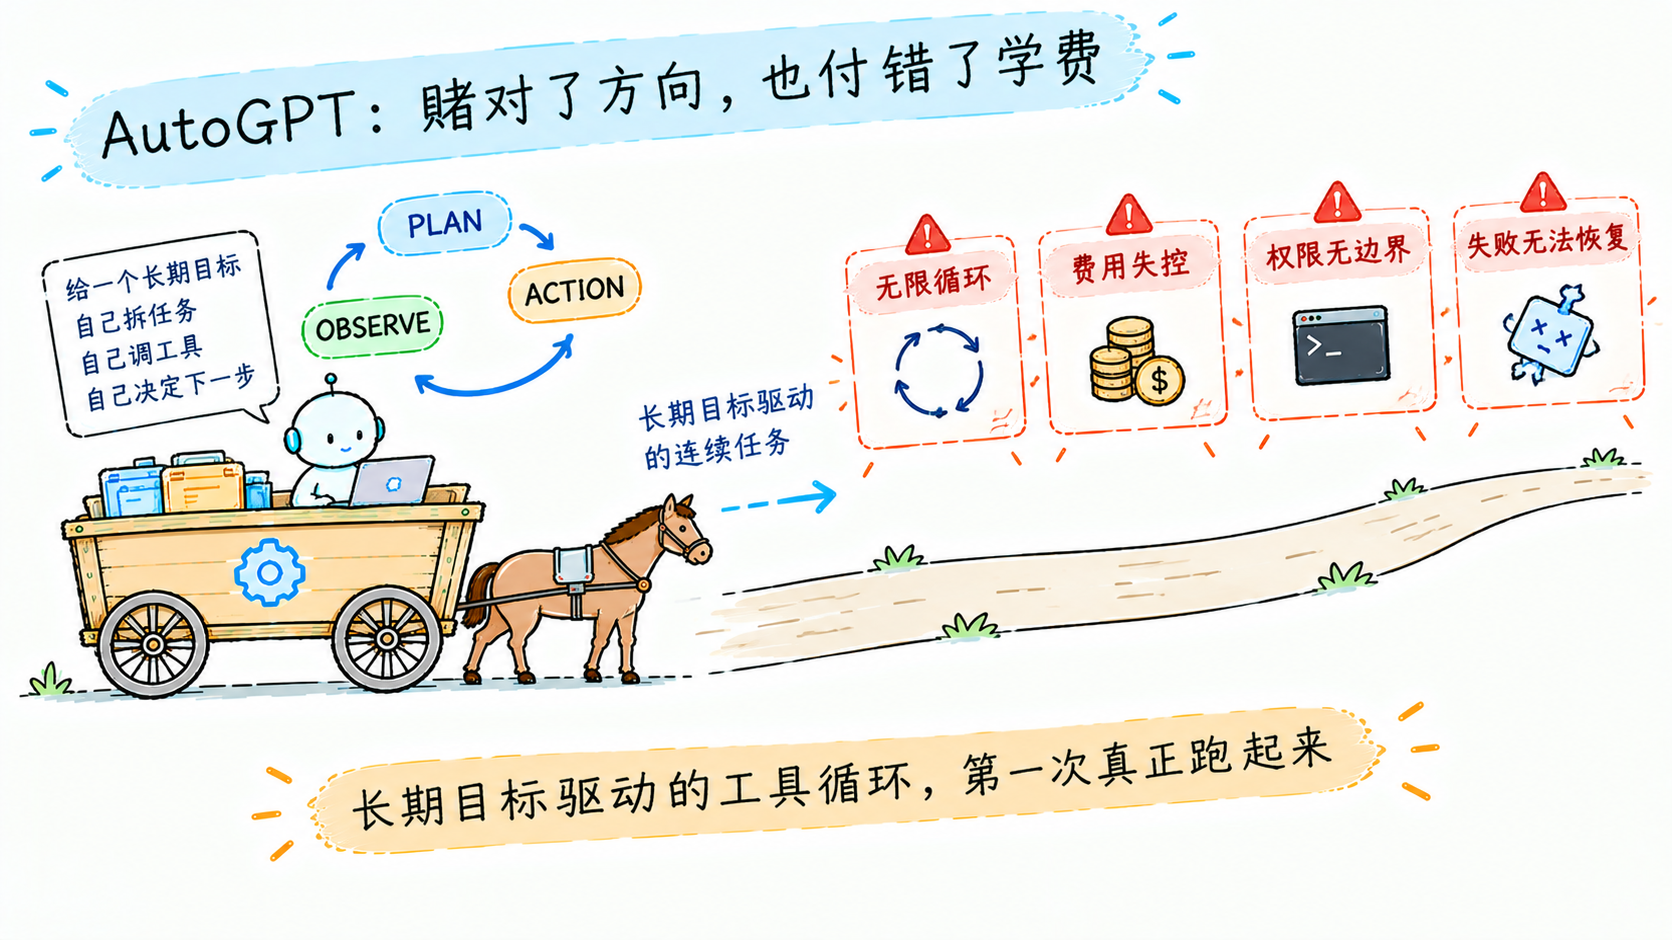
2023 年 3 月,AutoGPT 发布。它做的事今天看很朴素:给模型一个长期目标,让它自己拆任务、自己调工具、自己决定下一步,循环往复直到完成。这是"agentic loop"第一次以大众产品的规模跑起来。
它证明了一件事:长期目标驱动连续工具循环,是可行的形态。这个方向赌对了,今天所有 Agent 都沿用它。
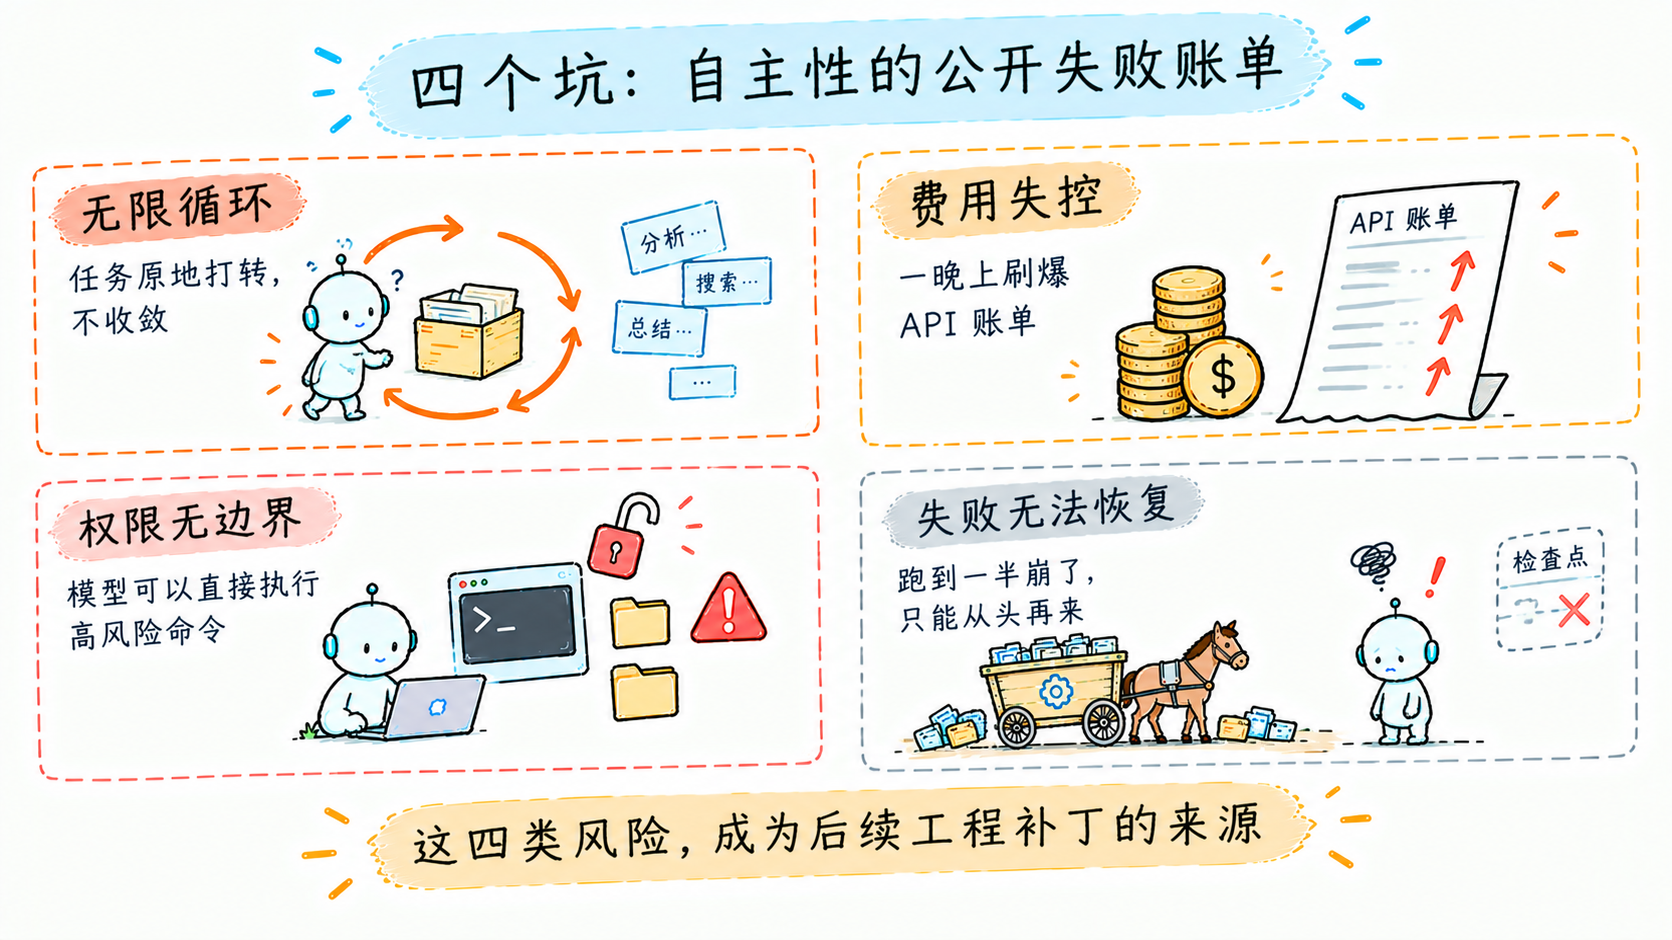
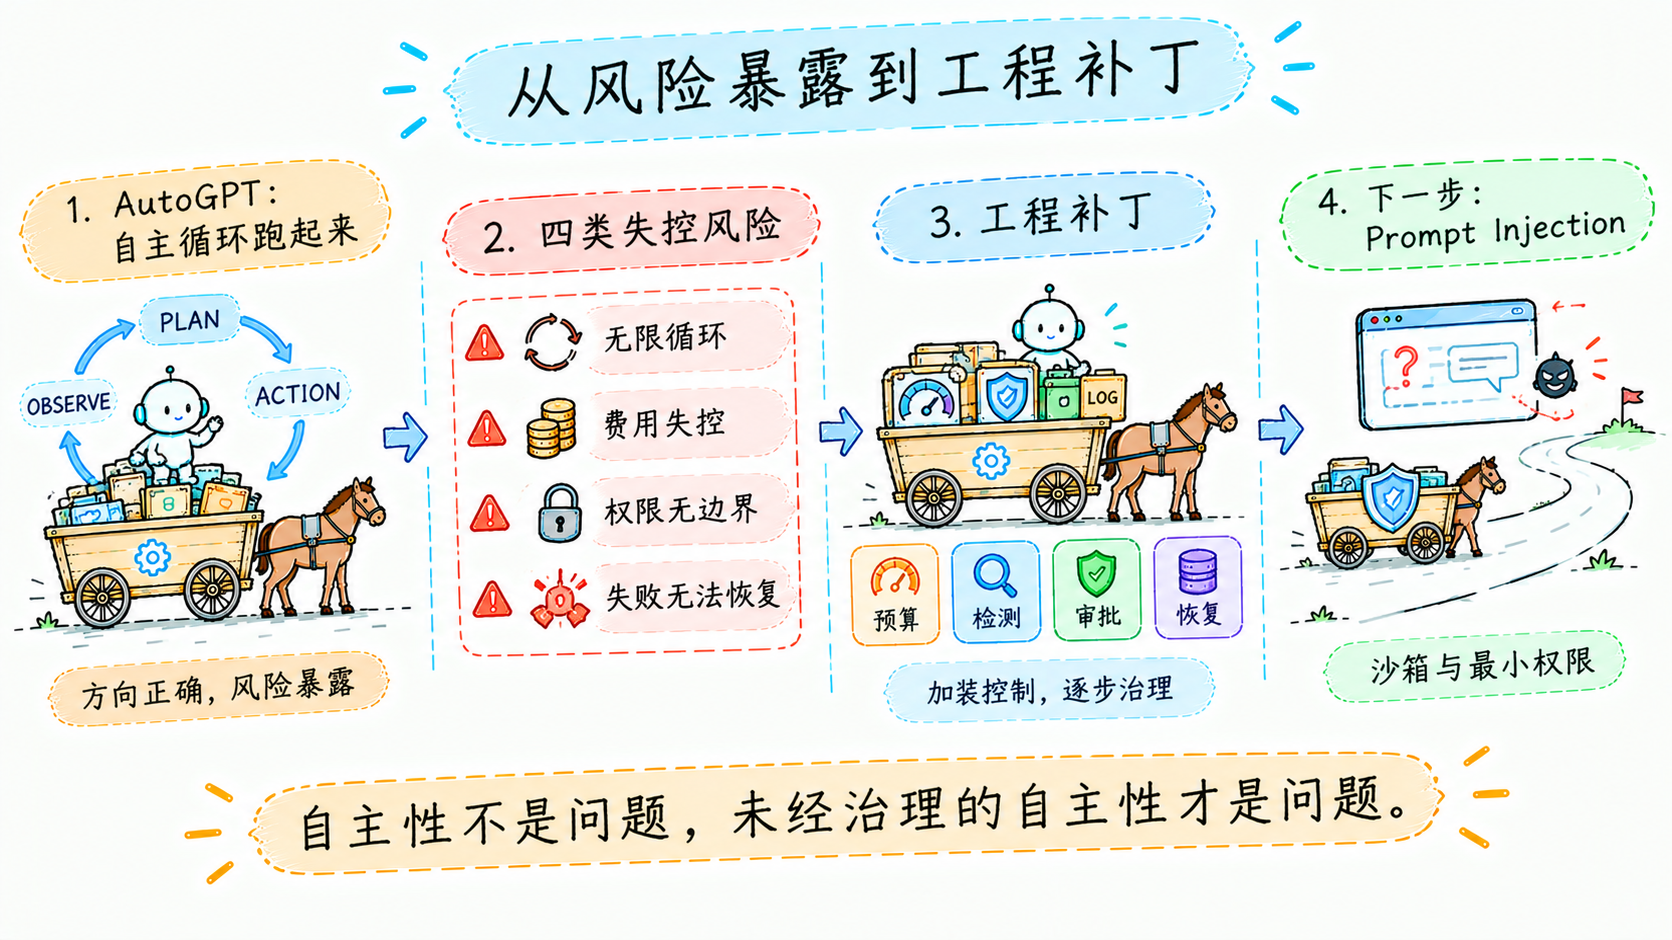
但账单也是公开的。当时用户踩到的坑,后人总结下来主要是四类:无限循环(任务原地打转不收敛)、费用失控(循环一晚上刷爆 API 账单)、权限无边界(模型直接在用户机器上执行命令)、失败无法恢复(跑一半崩了只能从头再来)。
这四类问题,就是链三全部概念的来源。
四个坑,对应四类补丁
第 0 篇埋过一个伏笔:说这些安全设施是"AutoGPT 催生的"是我的推断,不是文献记载。现在到兑现论证的时候了。
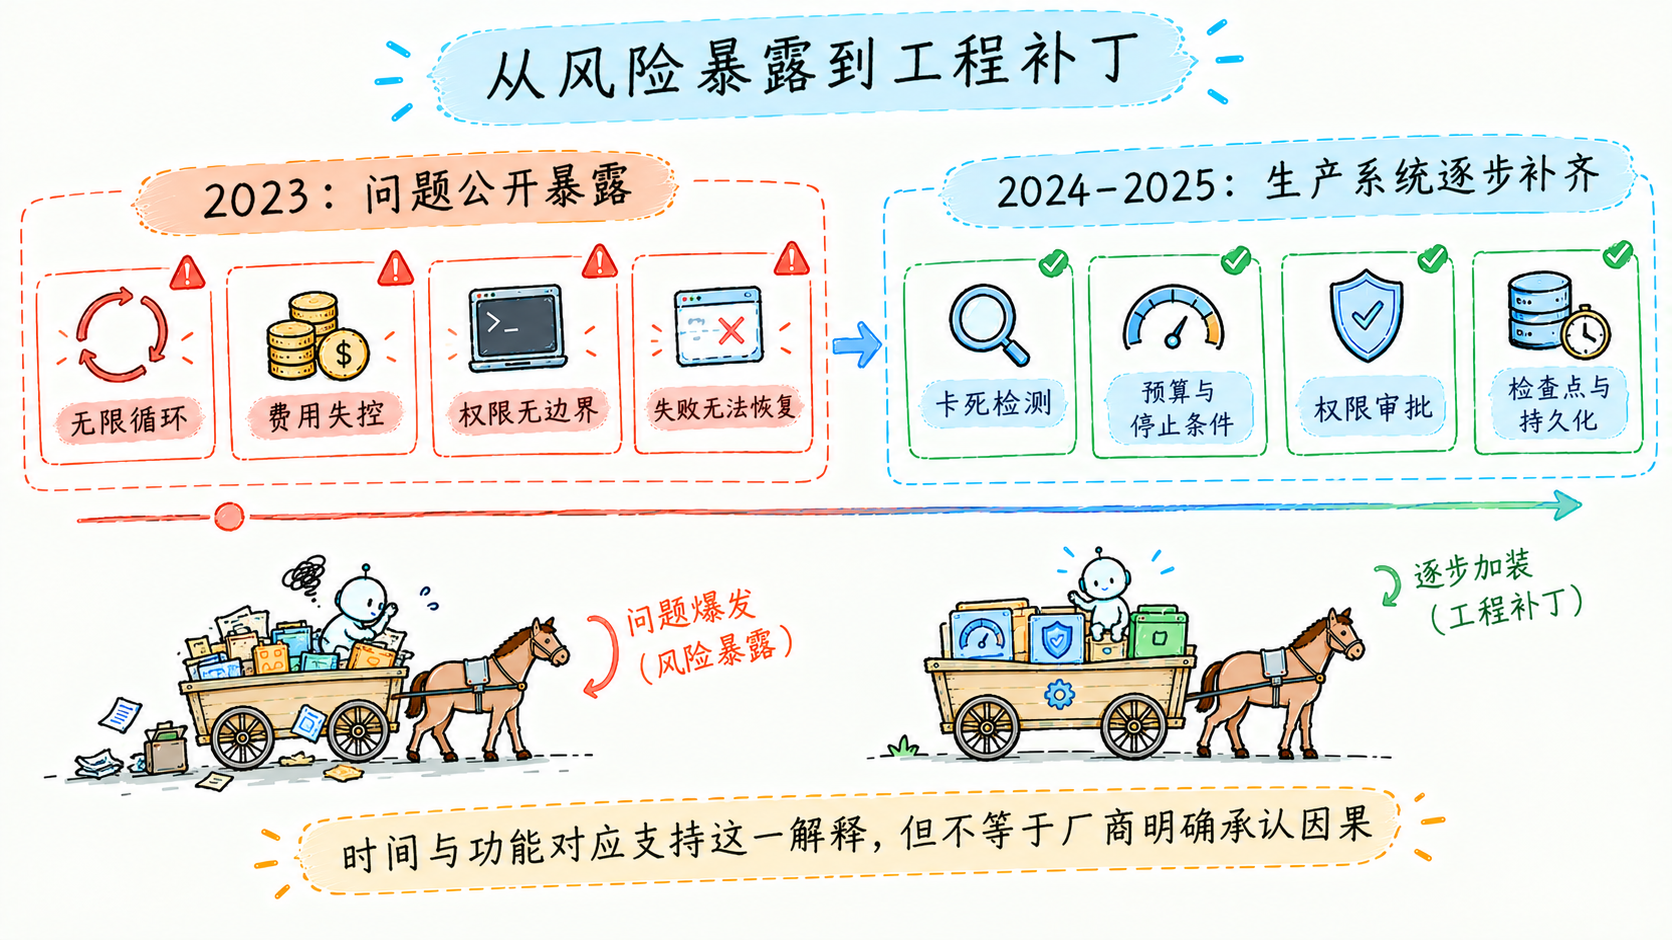
论证靠两个事实。一是时间:四类坑在 2023 年上半年公开可见,而补丁(预算、卡死检测、权限层、检查点)在 2024 到 2025 年才陆续出现在生产系统里,缺口在前,补丁在后。二是功能对应,逐条看:
- 无限循环,对应卡死检测:识别重复行为并打断;
- 费用失控,对应预算与停止条件:迭代次数、token、花费,任一触顶即停;
- 权限无边界,对应权限审批:动作执行前必须过审;
- 失败无法恢复,对应检查点与会话持久化:跑到一半崩了,能从上次的存档继续,而不是从头再来。
要诚实说明边界:没有任何厂商文档写过"我们这个功能是给 AutoGPT 擦屁股的"。上面的对应是我从缺口和补丁的功能匹配推出来的,合理的另一种读法是:这些问题本就是自主系统的通病,AutoGPT 只是第一个把它们演给大家看的。两种读法不冲突,都支持同一个结论:这类风险和这类补丁是配套出现的。
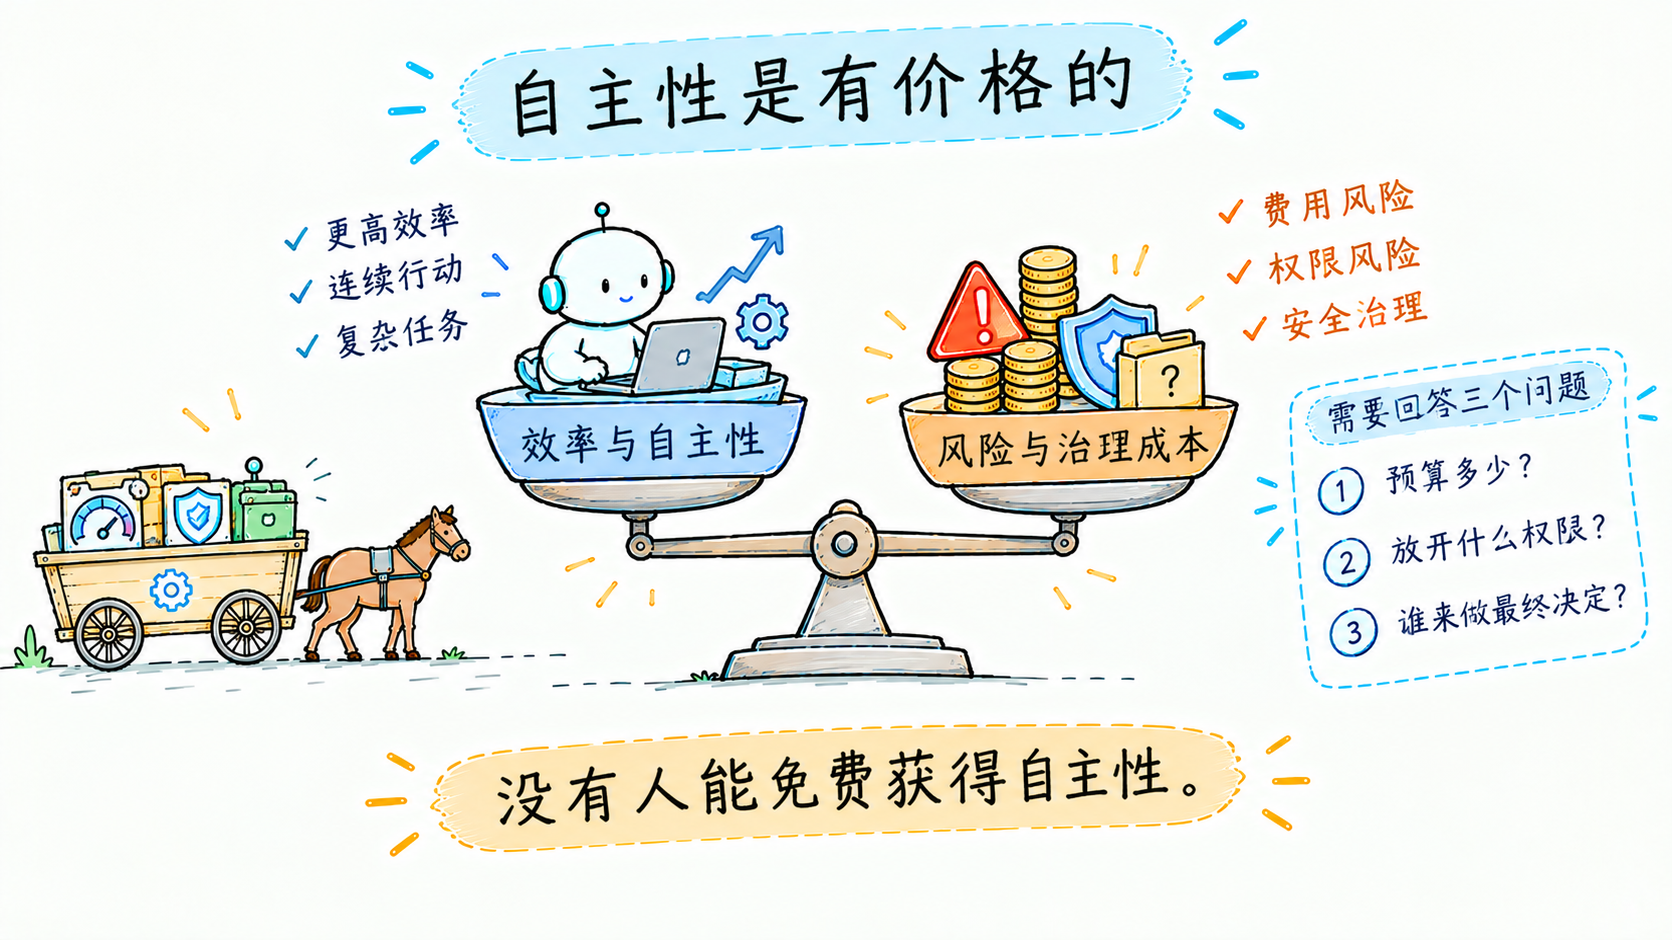
IMPORTANT: 自主性是有价格的。预算、检测、审批、沙箱,每一个安全设施都是这个价格的一个报价项:为多少效率,支付多少风险,买单的按钮交到谁手里。
给循环装仪表:预算与卡死检测
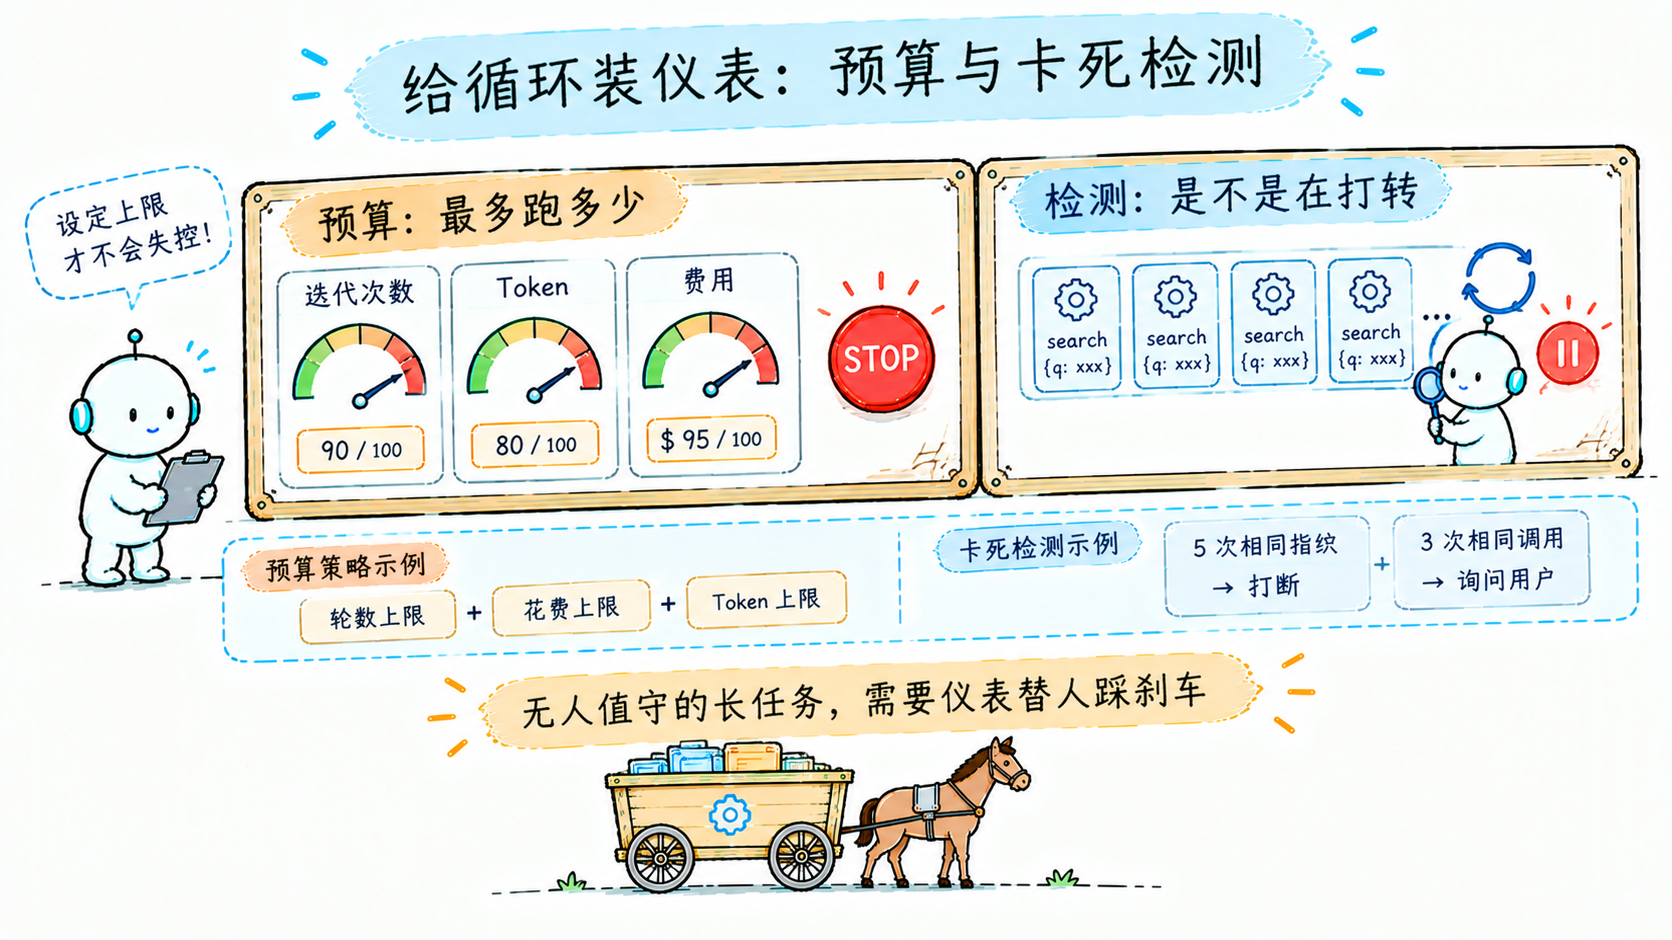
四个坑里,前两个(无限循环、费用失控)的解法是同一类东西:仪表。仪表分两种,各管一件事。预算管"最多跑多少":次数、token、钱,任一触顶就停。卡死检测管"是不是在原地打转":识别出重复行为并处理。
先说预算。它直接指向费用失控:循环一晚上刷爆账单的事,靠一个数字上限就能兜住。各家的做法都是定上限,细节有差别。Hermes 默认给每个轮次 90 次迭代,用完之前给模型最后一次机会,让它把结论说完再停。Gemini CLI 是硬性的会话轮数上限。Mistral Vibe 做成了一组可插拔的策略组件:轮数上限、花费上限、token 上限各是一个组件,按需组合。Hermes 还有一个更细的设计,防的是另一件事:一个回合里改了代码,收尾时必须拿出验证过的证据(测试跑过、编译通过),拿不出就被打回继续干。它防的是"声称做完了,其实没做"。
再说卡死检测。它回应无限循环:任务不收敛,模型在同一处反复打转。做法都是"识别重复",各家识别的力度不同。OpenHands 人工列举了五种典型卡法:同一动作反复做、反复报错、自言自语、来回横跳等。Gemini CLI 分两级:先把每次工具调用的名字和参数算成一个指纹,连续五次指纹相同直接打断,这个比对几乎不花成本;跑满三十轮之后,再加一道让模型自查。OpenCode 最克制:只数连续三次完全相同的调用,而且不自动打断,而是问用户,这算 bug 还是你在做重复的事?
这节真正的反直觉在缺席者。Claude Code 和 Codex 这两家旗舰,反而没有自动卡死检测,论文的说法是它们靠权限等其他机制兜底。pi 走得更远:循环没有步数上限、没有花费熔断,什么都不装,文档里明确写这是有意的选择,不是遗漏。我天天用 pi,短会话里这些仪表确实用不上;但代价也明摆着:一旦失控,没有东西会替我踩刹车。
所以仪表装不装,取决于部署场景:无人值守的长任务必须装,有人盯着的短会话可以省。不存在默认正义。
Permission:把"能不能做"从模型手里拿走
预算管"跑多久",权限管"能不能碰"。后者是链三最重的设施。
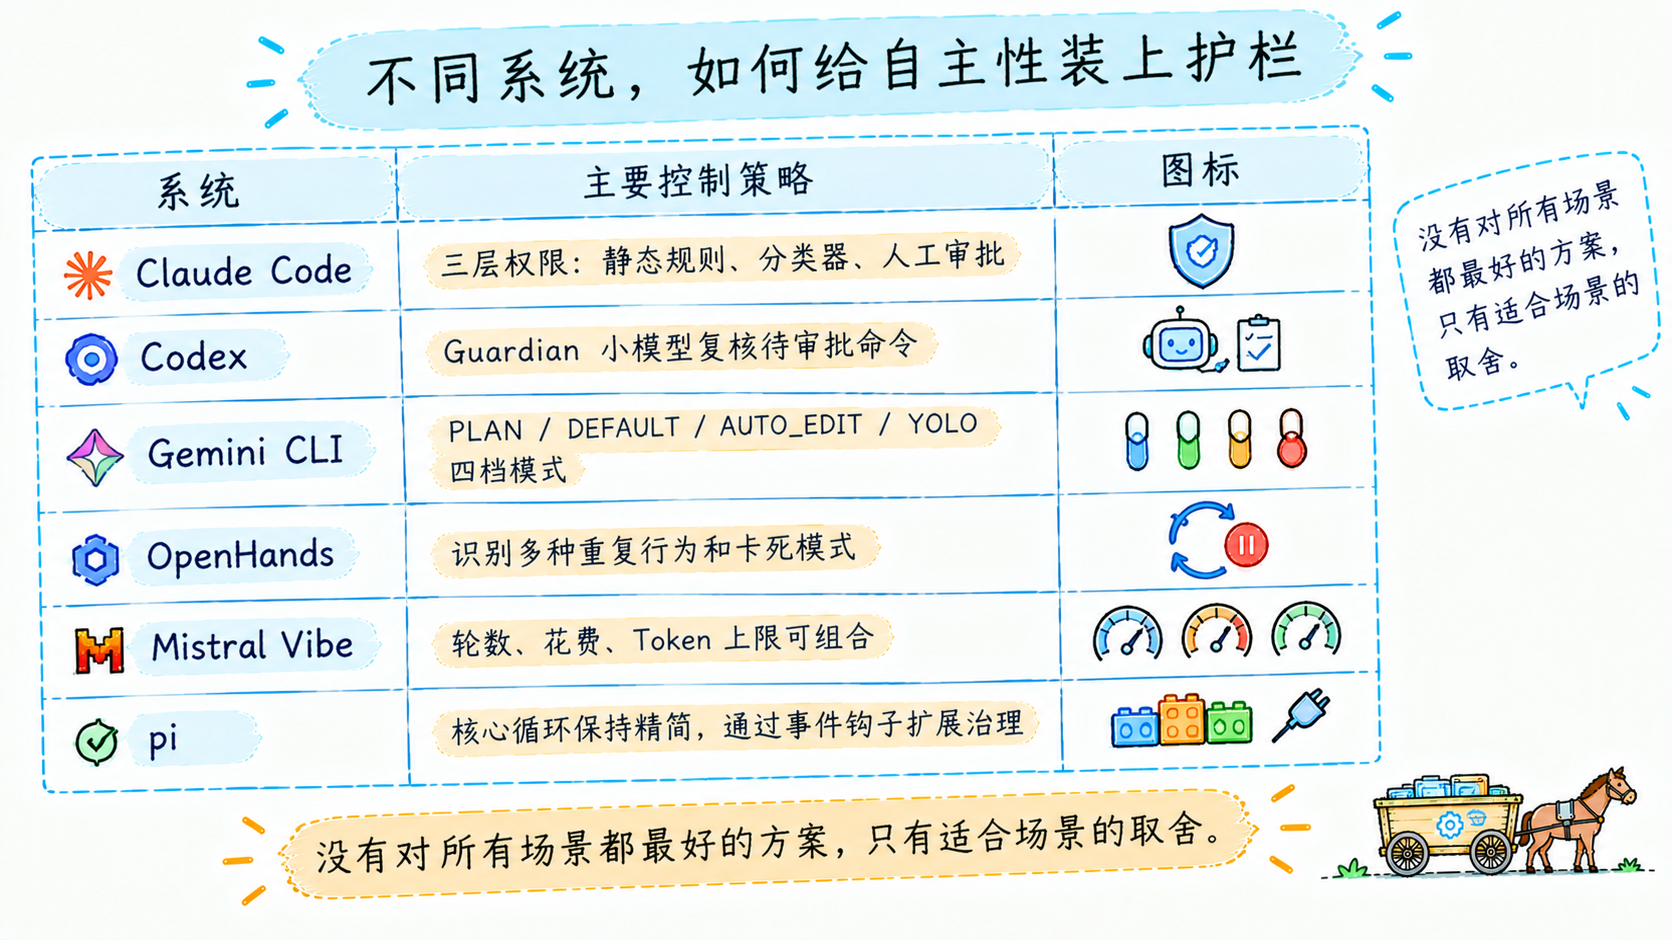
Claude Code 的权限是三层漏斗:最底层是静态规则(allow 和 deny 列表,毫秒级);中层是 LLM 分类器,对拿不准的命令做一次快速判断(比如认出 git status 是只读);顶层才是人工对话框。三层从快到慢、从便宜到贵,大多数调用在前两层就放行或拦截,只有真正模糊的动作才打扰人。Codex 后来加了一个 Guardian:专门的小模型复核每一个待审批命令,超时或输出异常一律按拒绝处理。
Gemini CLI 把这件事做成了用户可选的四档模式:PLAN 只读、DEFAULT 逐次询问、AUTO_EDIT 自动放行编辑但拦截其他写操作、YOLO 全放行。命名很诚实,YOLO 就是 YOLO。
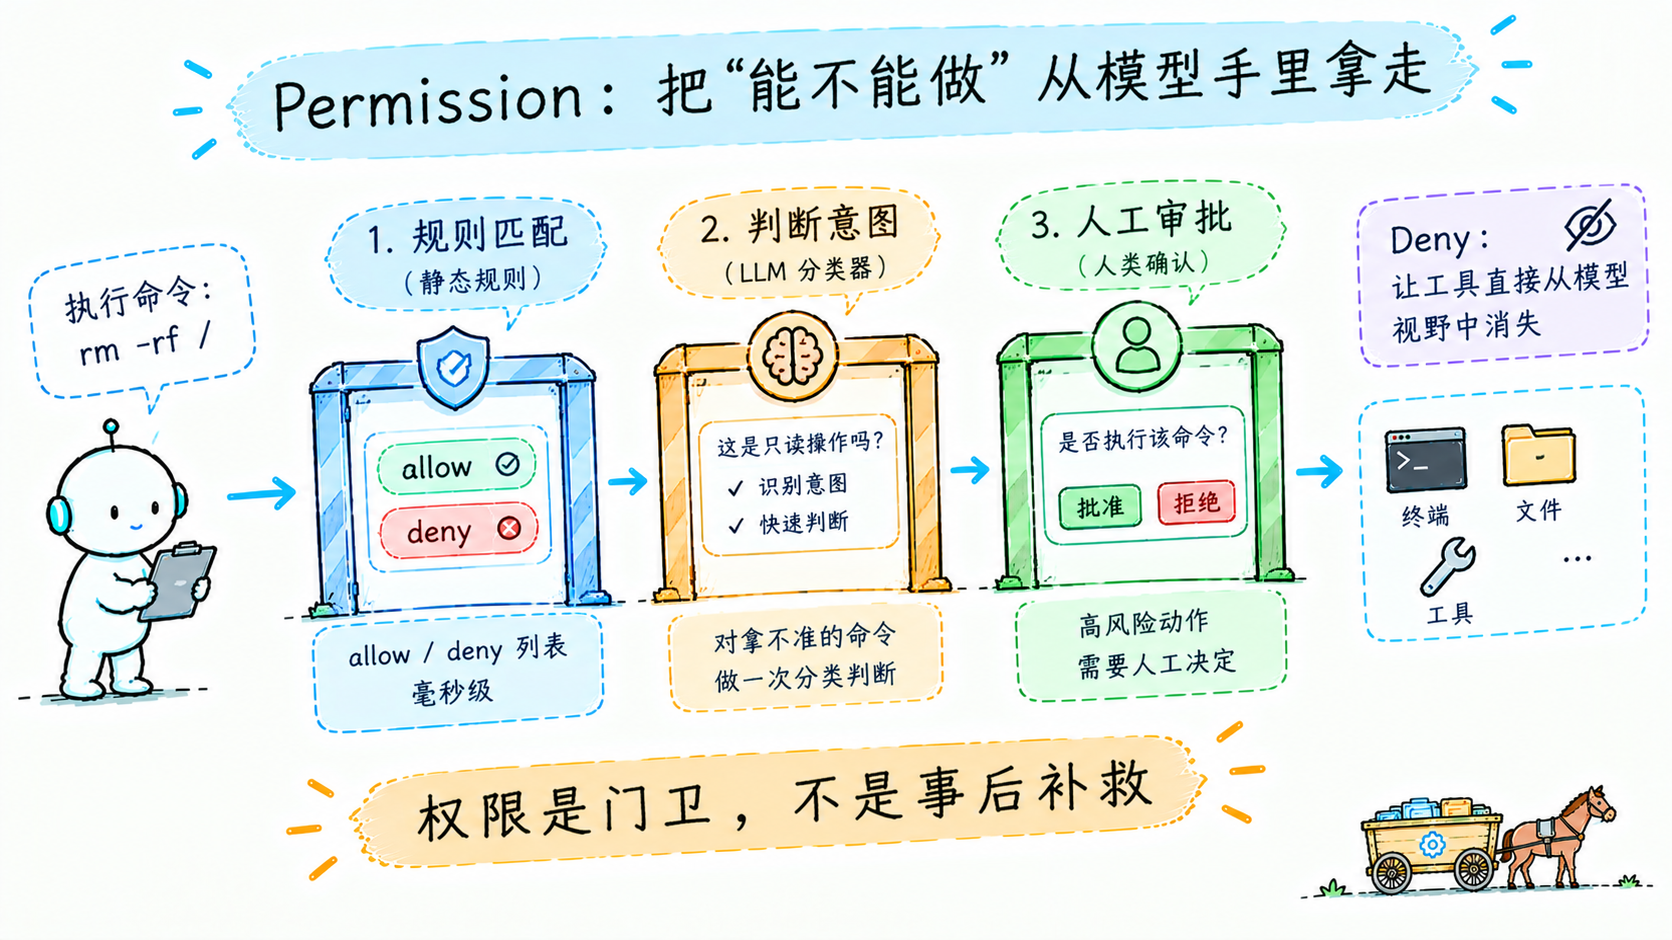
还有一个容易忽略的细节:deny 不是"拦下来",是"看不见"。权限规则可以把一个工具从模型的视野里整个移除,模型连"有个东西不让我用"都不知道。这比"尝试后被拒"干净,也省了来回拉扯的 token。
pi 在这里的立场很典型:核心循环不带权限层,但提供完整的事件钩子,权限作为扩展挂上去。我自己就写过一个路径白名单扩展,白名单目录随便读写,目录之外一律拦截。核心保持极小,治理按需加装,这是最小内核流派的一贯答案。
写在最后
链三到这篇讲了一半:模型自己乱来的风险,用仪表(预算、检测)和门卫(权限)管住了。
但还有一类风险没讲:不是模型想乱来,是别人借模型的手乱来。agent 要读网页、读文件、读工具返回,如果这些内容里藏着给模型的指令呢?下一篇讲 prompt injection 和它的防线,沙箱、最小权限也一起收尾。
参考资料
- Harness Engineering: Anatomy, Architecture, and Evolution of Coding Agents(预算与卡死检测见 §6,权限三层与四档见 §10)
- Agent 工程史:从工具循环到可靠运行时(AutoGPT 暴露的四类问题清单出处)
- 本系列第 6 篇:(6)Subagent:给活干不完的模型派分身