
(4)从 ReAct 到 Function Calling:文本怎么变成动作
写在前面
上一篇结尾换了链:链一讲完上下文,链二讲行动。这条链的起点是一个再朴素不过的事实。
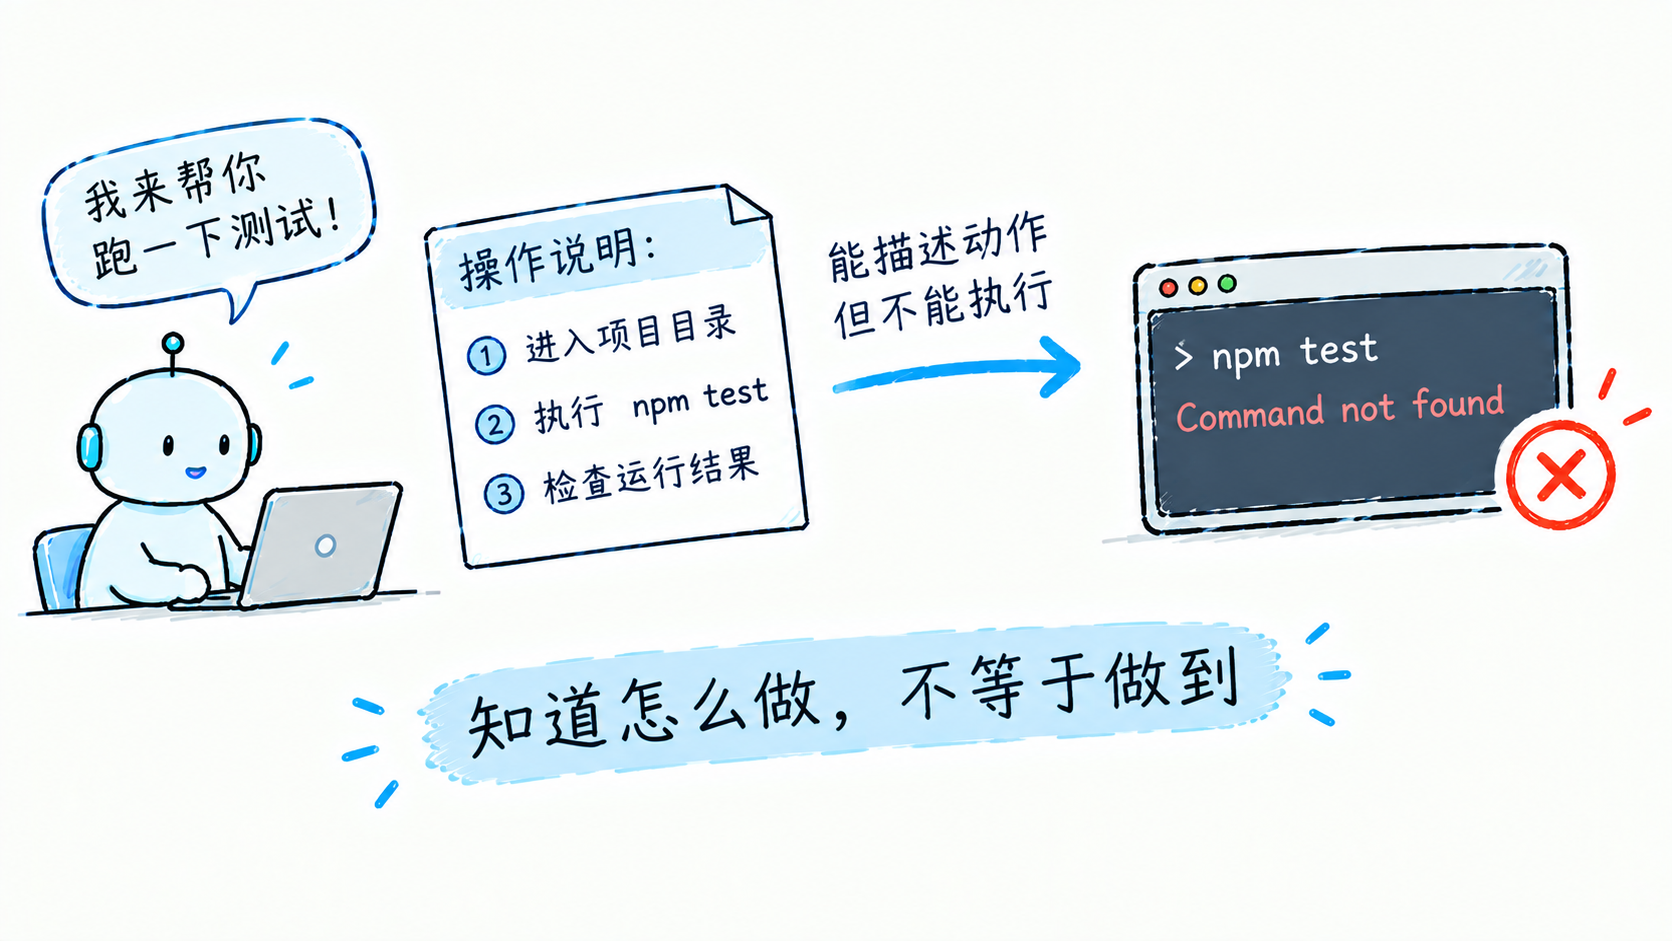
你对模型说"帮我跑一下测试",它会输出一大段说明:用什么命令、注意什么参数、失败了怎么排查。说得头头是道,但它跑不了。它能描述动作,不能执行动作。
知道,不等于做到。这中间的鸿沟,2022 年先有了一个能跑的方案,但并不牢靠,2023 年才真正稳下来。这篇讲这段路。
ReAct:让模型边想边做
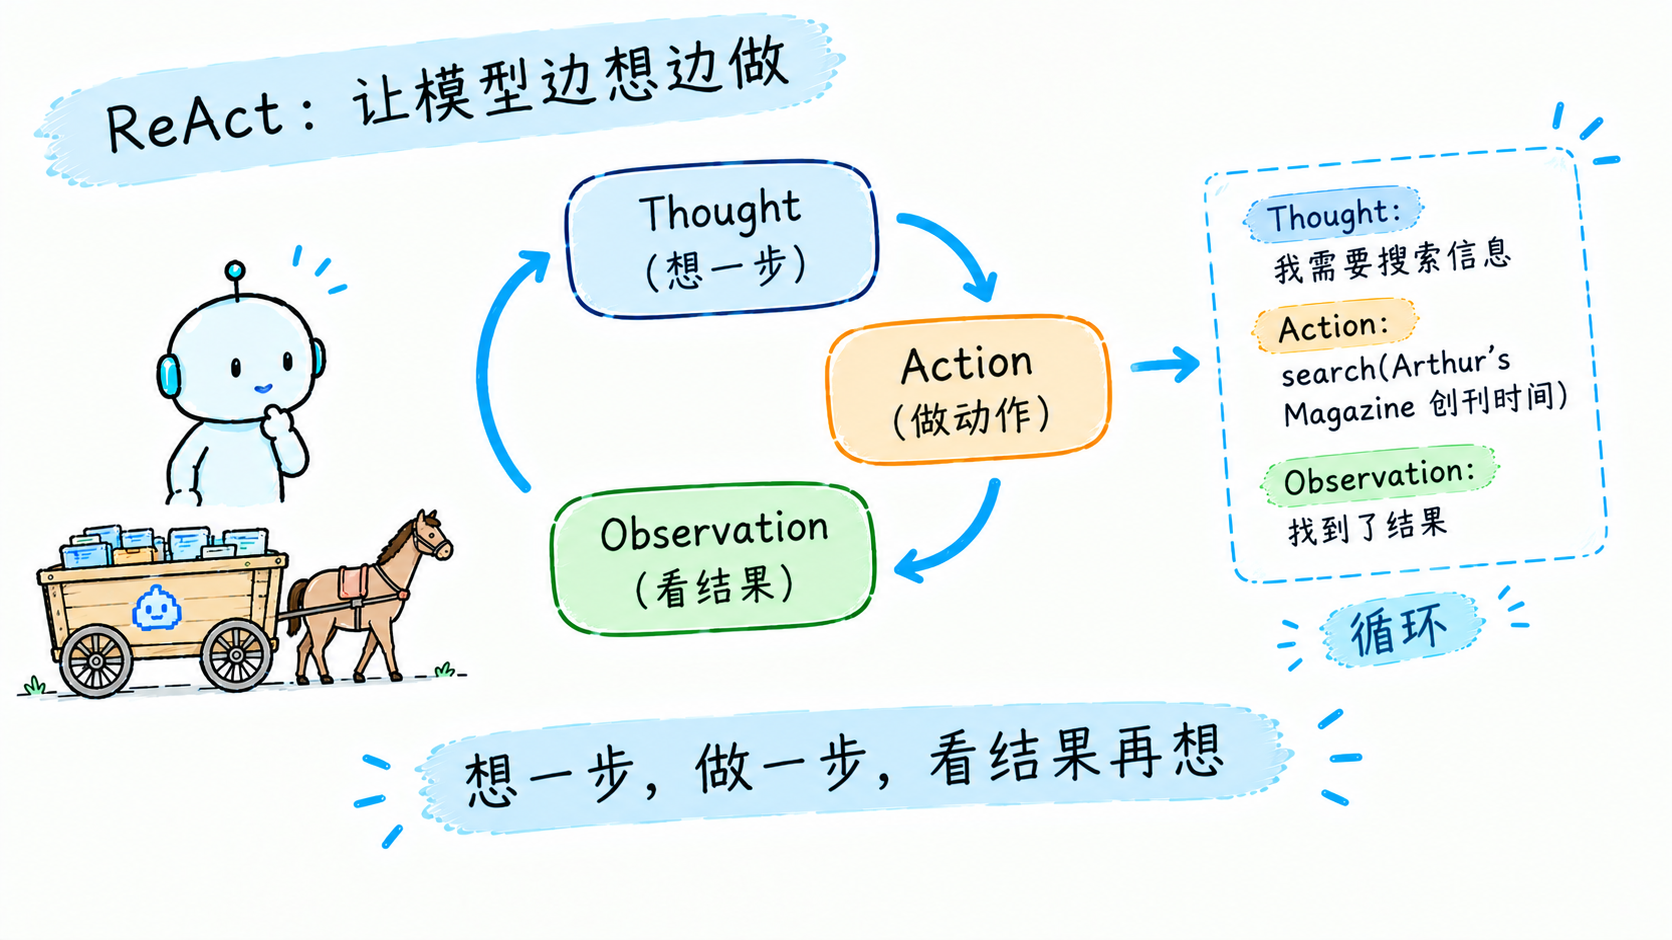
2022 年 10 月,ReAct 论文给出了第一个通用答案:让模型的推理和行动交织进行。
做法在今天看简单得不像论文:提示词里教模型按"Thought、Action、Observation"三段式输出。想一步(Thought),发一个动作(Action,比如搜索某个关键词),环境返回结果(Observation),再想下一步。循环往复,直到给出答案。
这个格式的价值不在准确率,在两点。一是把推理摊开在桌面上:每一步为什么这么做,轨迹里看得清清楚楚,出错能定位。二是它纯靠提示词就能驱动,不改模型一行权重,任何模型都能试。
Agent 这个形态,"想一步、做一步、看结果再想",就是从这里定型的。第 0 篇讲过的 agentic loop,原型就是它。
自由文本的动作,解析器猜不中
但 ReAct 有个先天缺陷:动作写在散文里。
模型输出"让我搜索一下 Arthur's Magazine 的创刊时间",应用得靠解析器从这句话里抠出真正的调用:函数名是什么、参数是什么。模型今天用这个句式,明天换个说法,解析器就猜不中。格式一变,动作就丢。
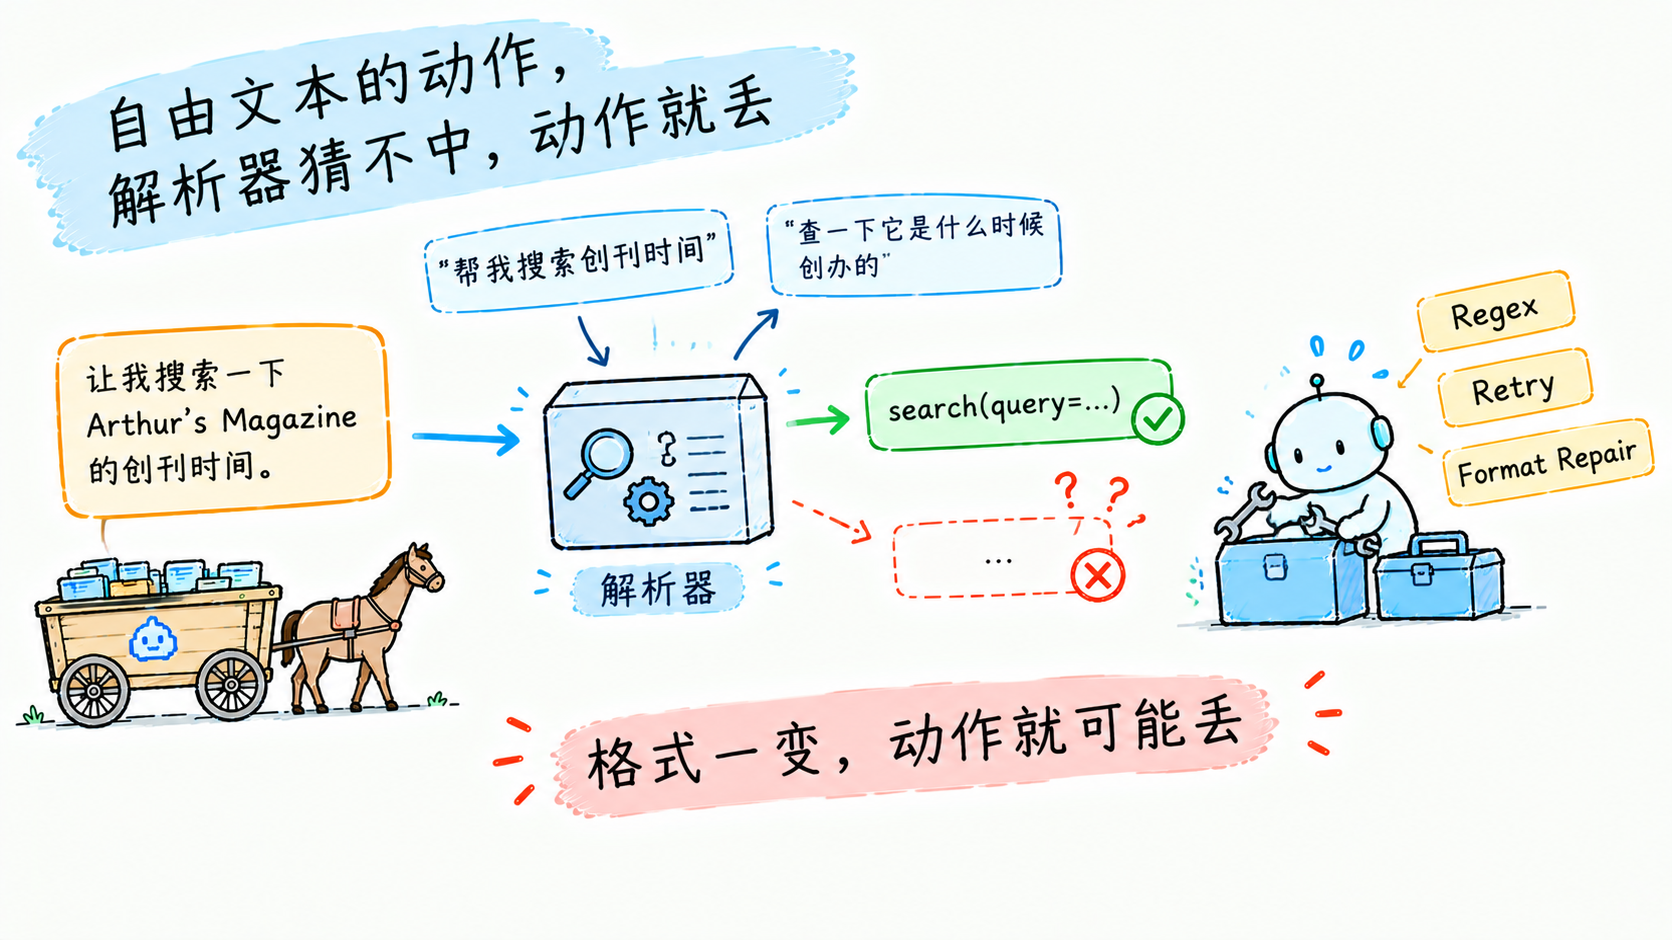
所以那个阶段的工具集成,大量工程量花在"猜模型的话"上:正则、重试、格式纠正。Gustafson 那篇演进史里有个很好的对照实验:同一段任务流程,自由文本动作和结构化动作走下来,控制流完全一样,差别只在自由文本需要一个时刻可能猜不中的解析器。
Function Calling:把动作变成契约
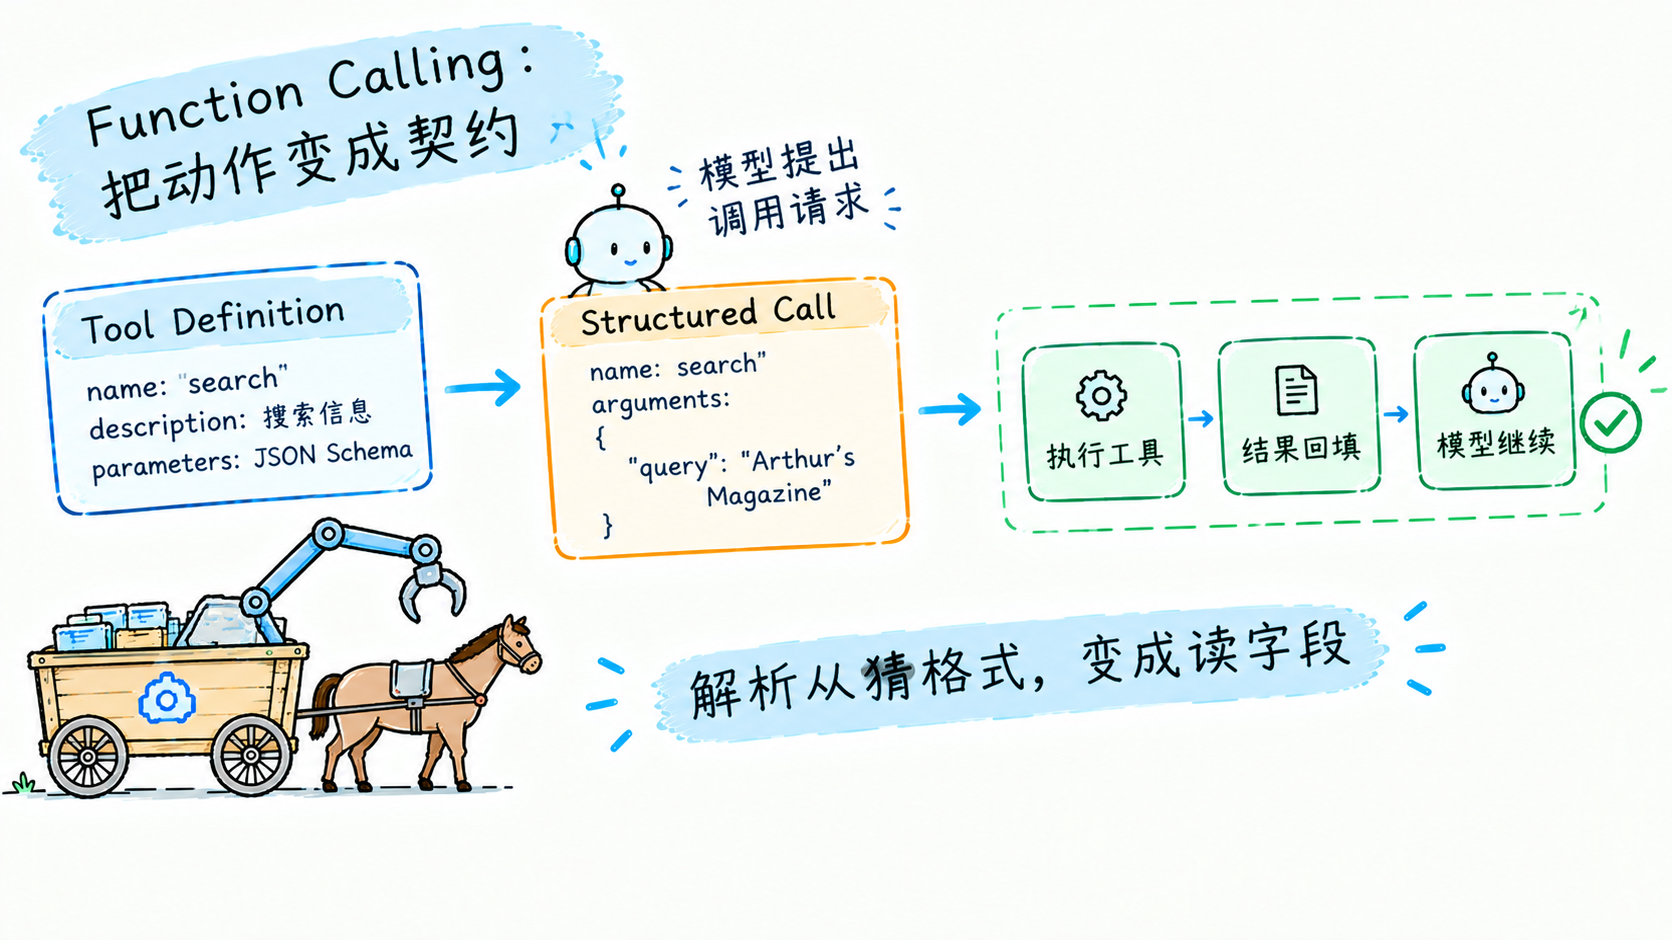
2023 年 6 月,OpenAI 发布 Function Calling,动作从散文变成了结构。
机制一句话说清:应用在请求里声明可用的函数(名字、用途、参数的 JSON Schema),模型想调用时,不再写一句话,而是输出一个结构化的调用请求;应用执行后把结果回填,模型继续。解析这一步从"猜"变成了"读字段"。
从 ReAct 论文(2022 年 10 月)到 Function Calling 落地(2023 年 6 月),八个月。范式是研究侧定的,产品化是工程侧完成的。
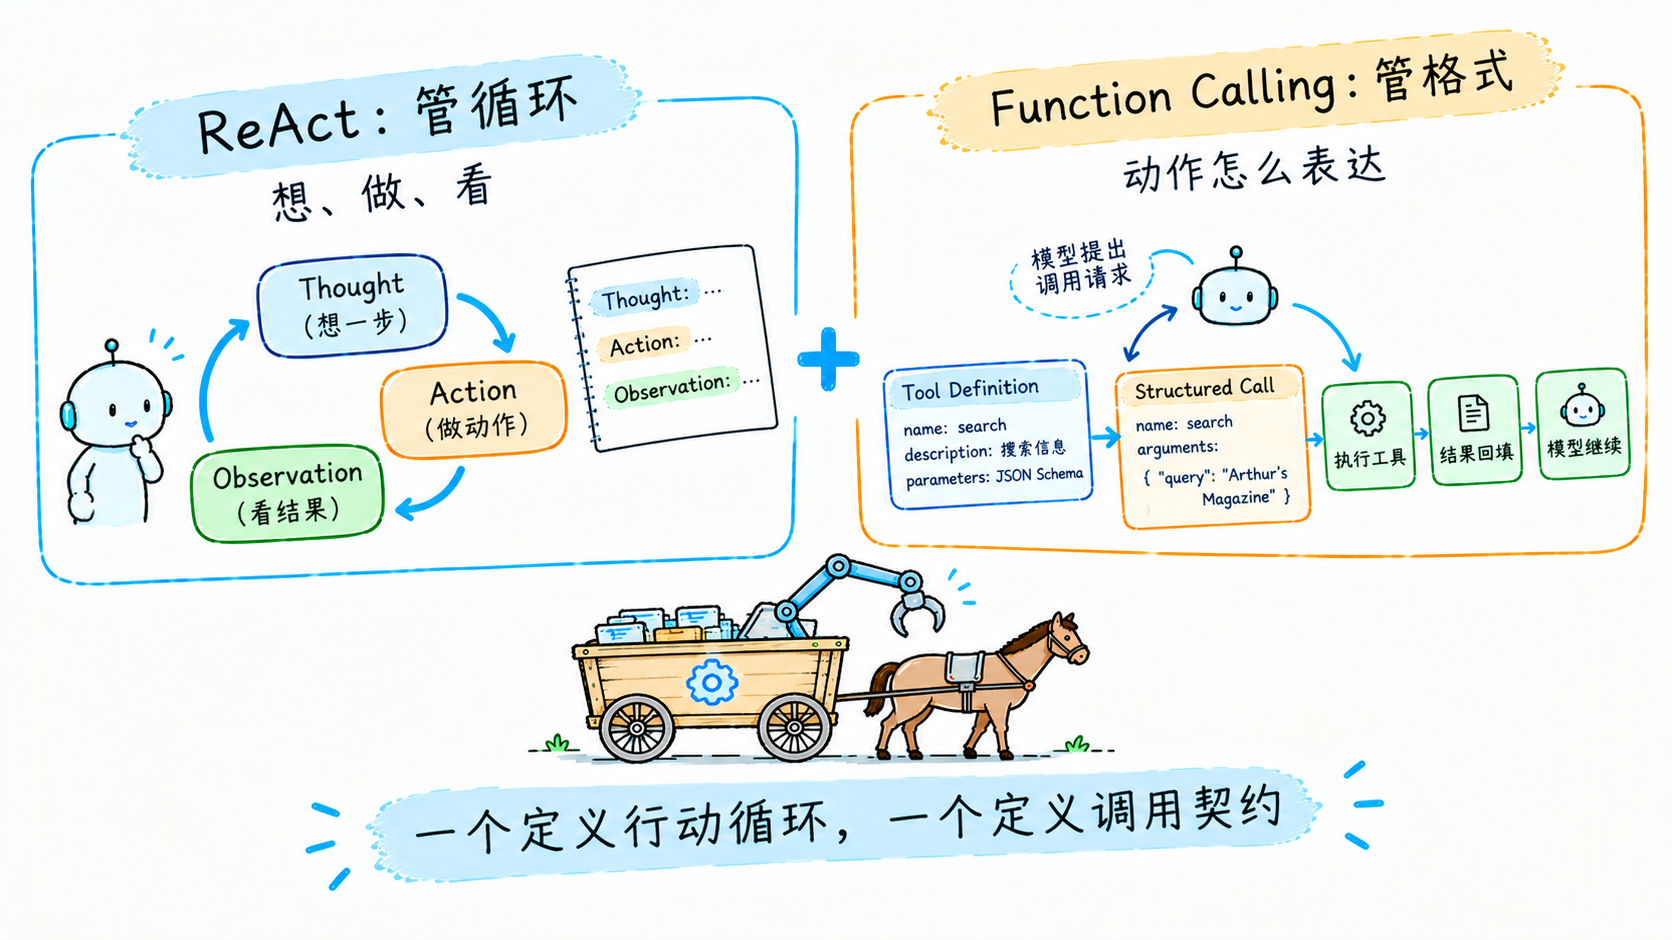
IMPORTANT: Function Calling 没有让 ReAct 过时。ReAct 管的是循环(想、做、看),Function Calling 管的是格式(动作怎么表达)。前者是行为模式,后者是接口契约,两层各管各的,今天的 Agent 两个都在用。
结构化还附赠了红利:参数可以校验,多个无依赖的调用可以并行执行,失败的调用能精确重试。这些在散文时代都做不到。
接口本身就是成绩变量:ACI
Function Calling 解决了"动作怎么表达",接下来一个更隐蔽的问题浮出来:动作的接口怎么设计。
2024 年的 SWE-agent 论文给了一个实验结论:同一个模型,配不同的工具接口,解决真实 GitHub issue 的成绩差很多。工具接口不是传输管道,是成绩变量。这就是 ACI(Agent-Computer Interface)的概念:给模型的接口,和给人的接口一样值得设计。
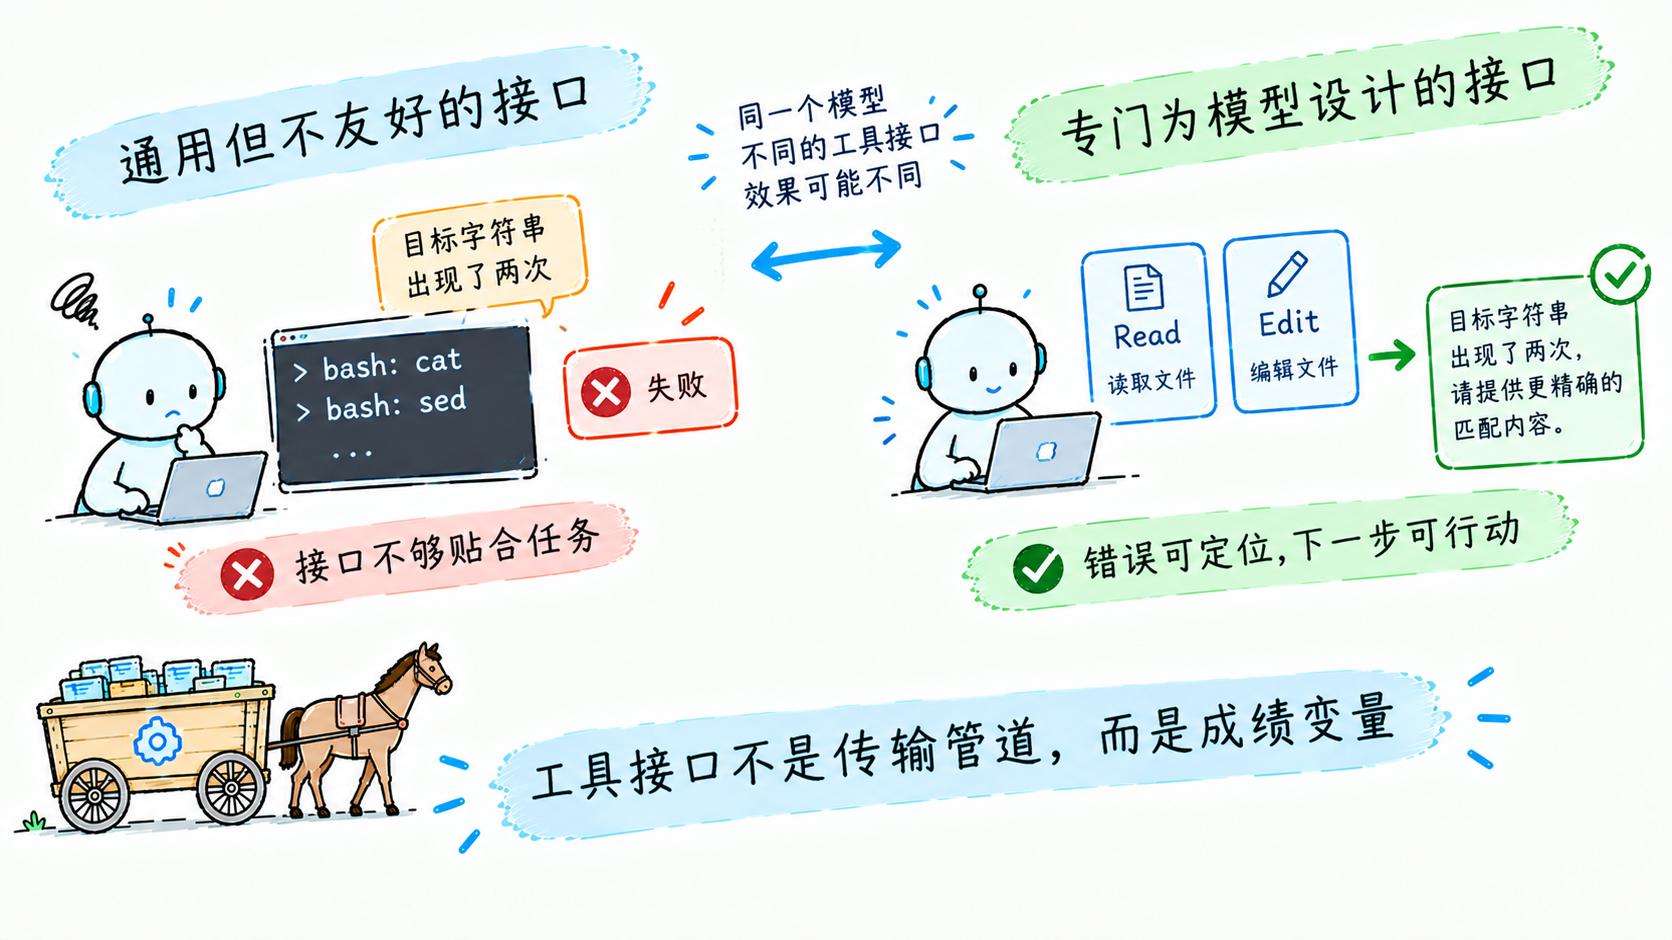
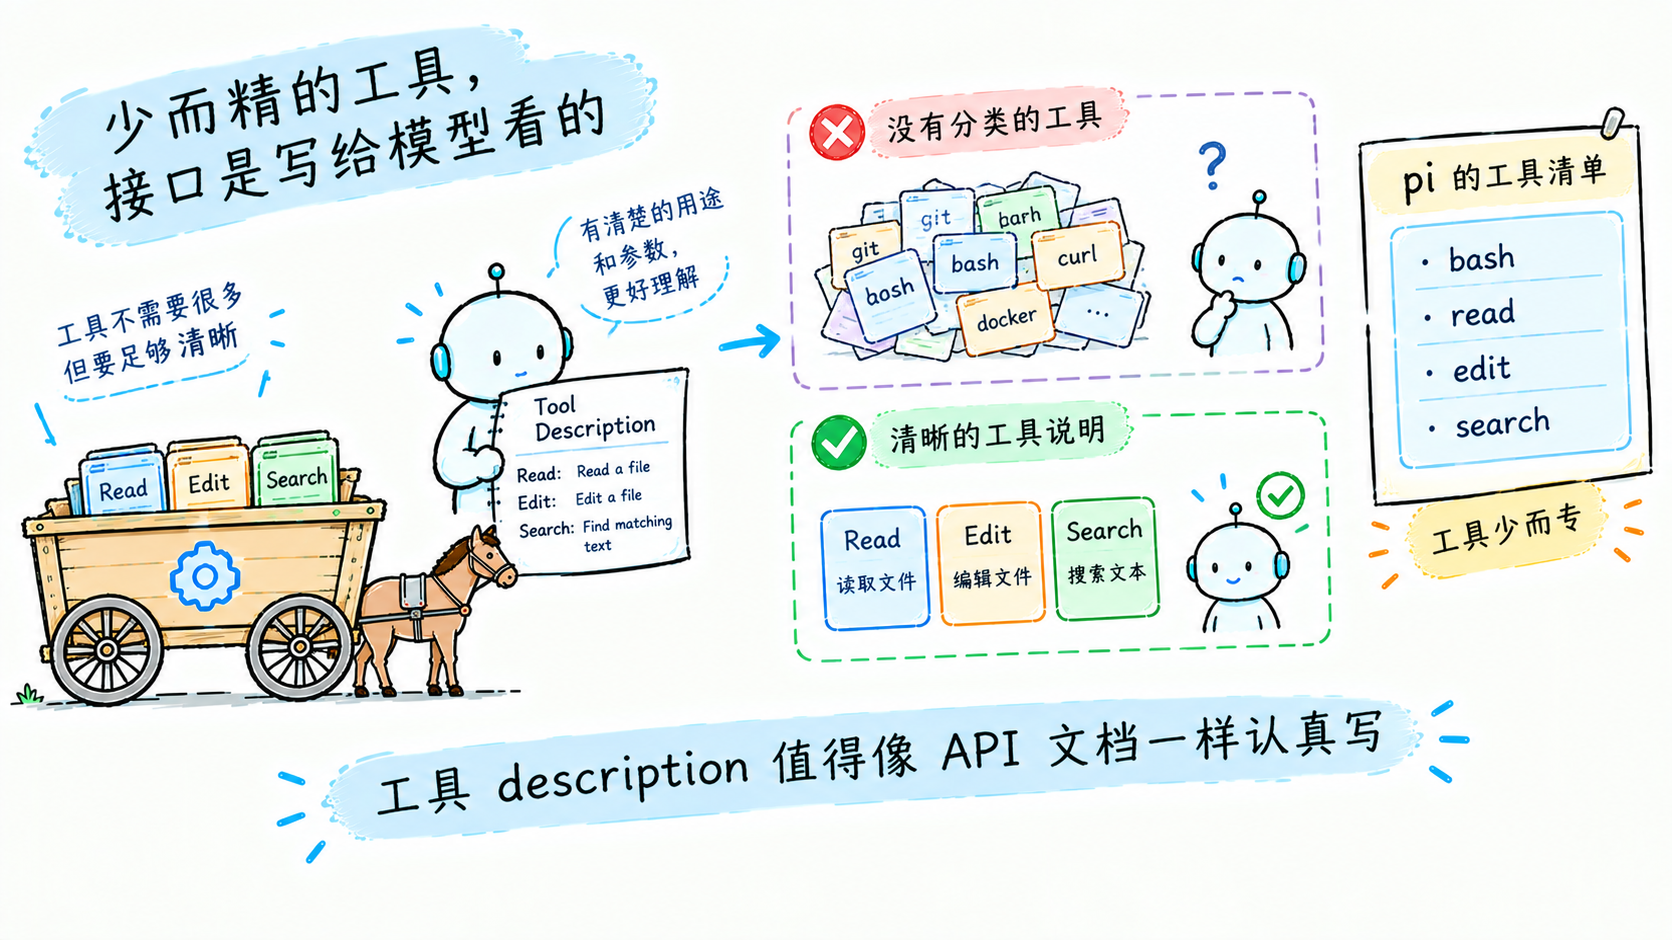
具体的例子:让模型用 bash 的 cat 和 sed 读写代码,不如给它专门的 Read 和 Edit 工具;Edit 工具报错时说"目标字符串出现了两次",比说"失败"有用得多。Anthropic 后来把这条经验写进了官方指南,标题就叫"少而精的工具",还报告了只靠打磨工具描述就提升基准成绩的案例。
pi 在这点上是个好标本:它只内置七个工具,默认只暴露四个,grep 和 find 背后自动下载的是 ripgrep 和 fd。工具少而专,每个都是为模型设计的接口。
TIP: 工具的 description 是写给模型看的接口文档,值得像写 API 文档一样认真写。多数人在这上面花的心思,远少于写给人看的文档。
写在最后
链二前半段串起来:模型只会输出文本(先天事实),ReAct 让文本有了行动的格式,自由文本的动作靠解析器猜、猜不中就丢,Function Calling 把动作变成契约,ACI 进一步说明接口设计本身就影响成绩。
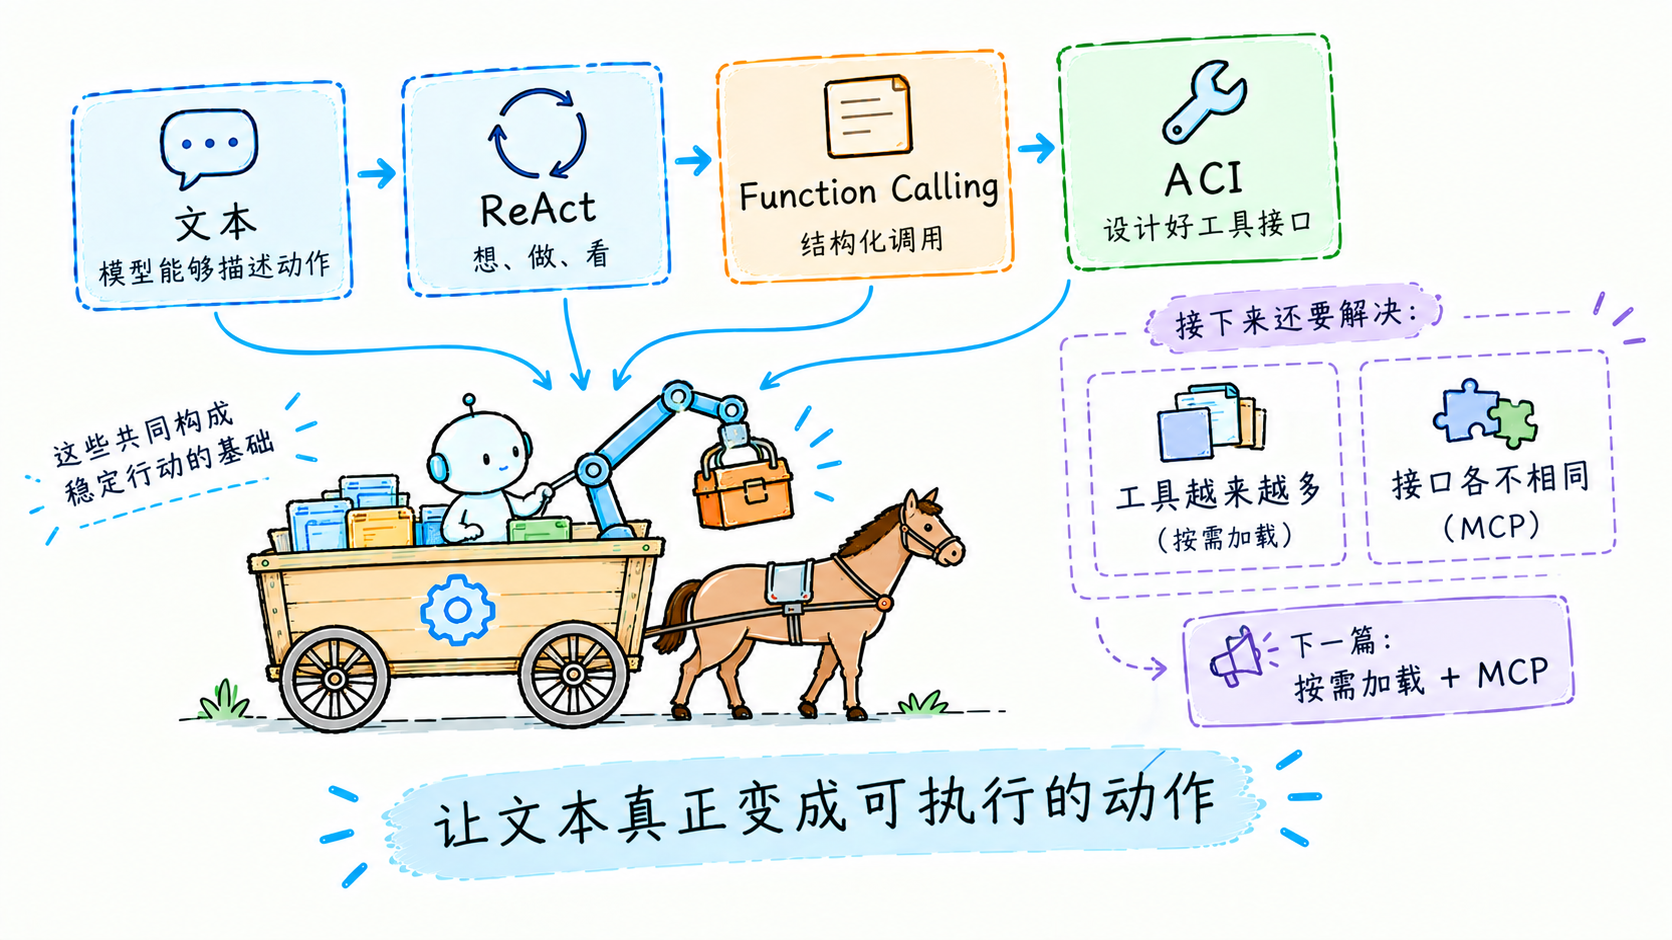
动作稳定之后,新问题立刻出现:工具越接越多,从 1 个 bash 涨到 100 多个,提示词装不下了;而且各家都实现了自己的工具调用,接口互不相同。下一篇讲这两个问题的答案:工具的按需加载,和 MCP。