
(3)装不下就放外面:存哪里,怎么取
写在前面
上篇结尾说,压缩解决不了信息的持久性问题。"装不下就放外面"包含两个子问题:重要的东西放在外面哪里,以及要用的时候怎么取回来。
这篇把两个问题一起讲完。先说存,再说取。取的那半段里有个很多人关心的悬案:为什么那篇解剖 11 个 Agent 的论文里,400 万行源码没有一家用向量 RAG 读代码。
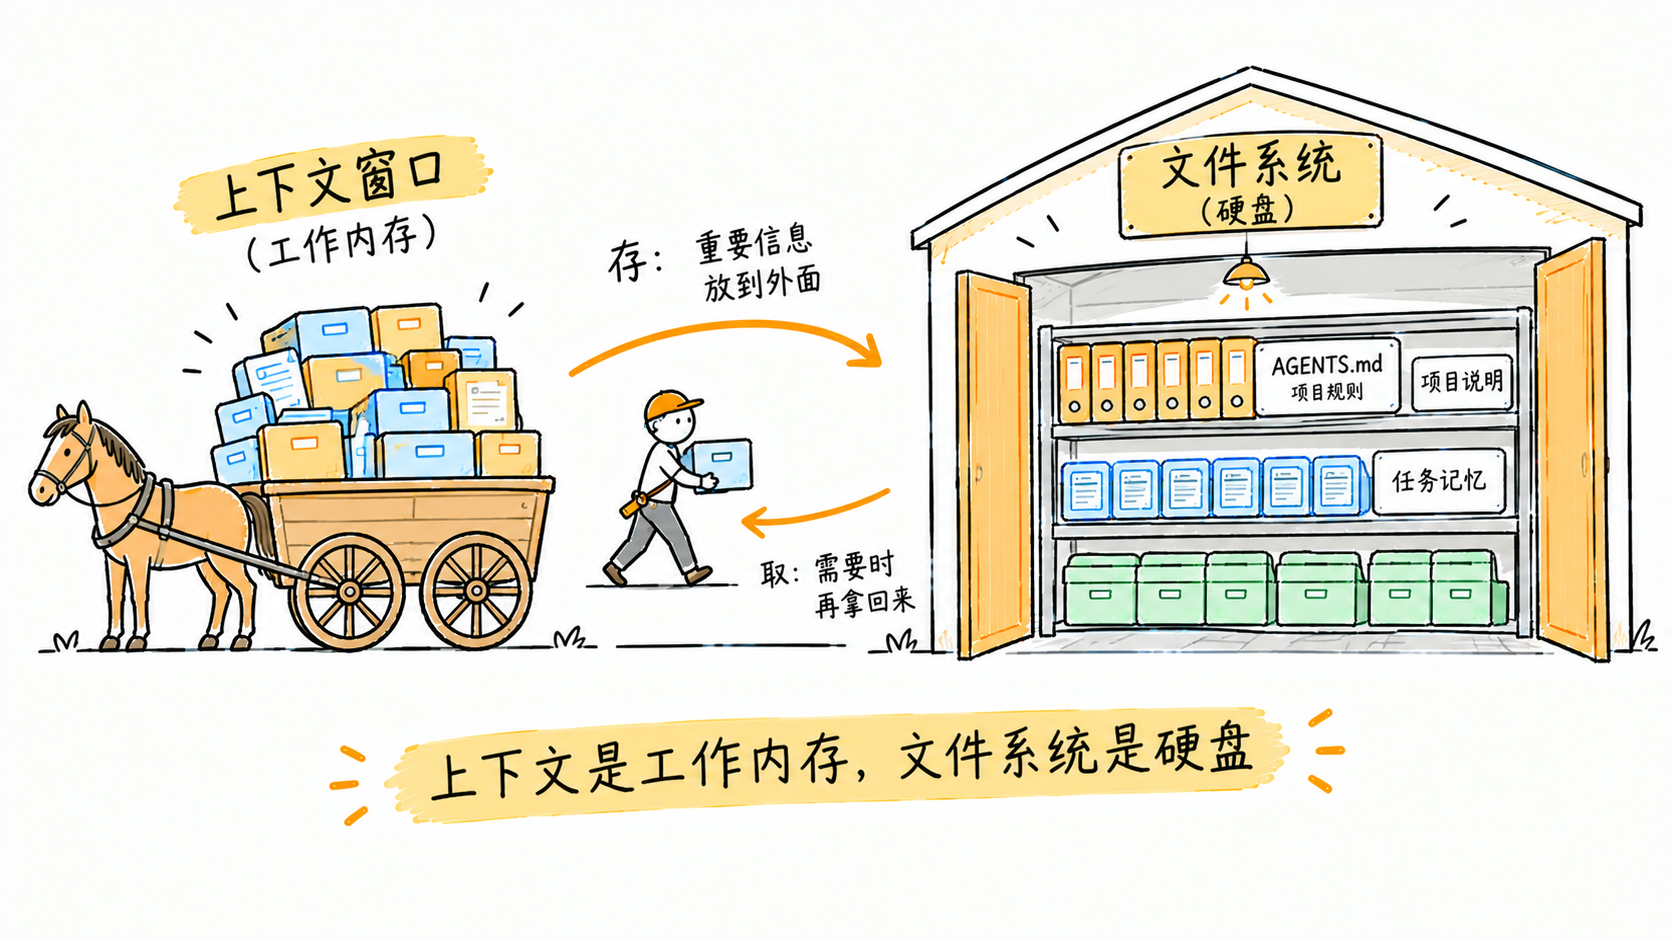
存的第一去处:文件系统
最自然的存储介质一直就在那里:文件系统。
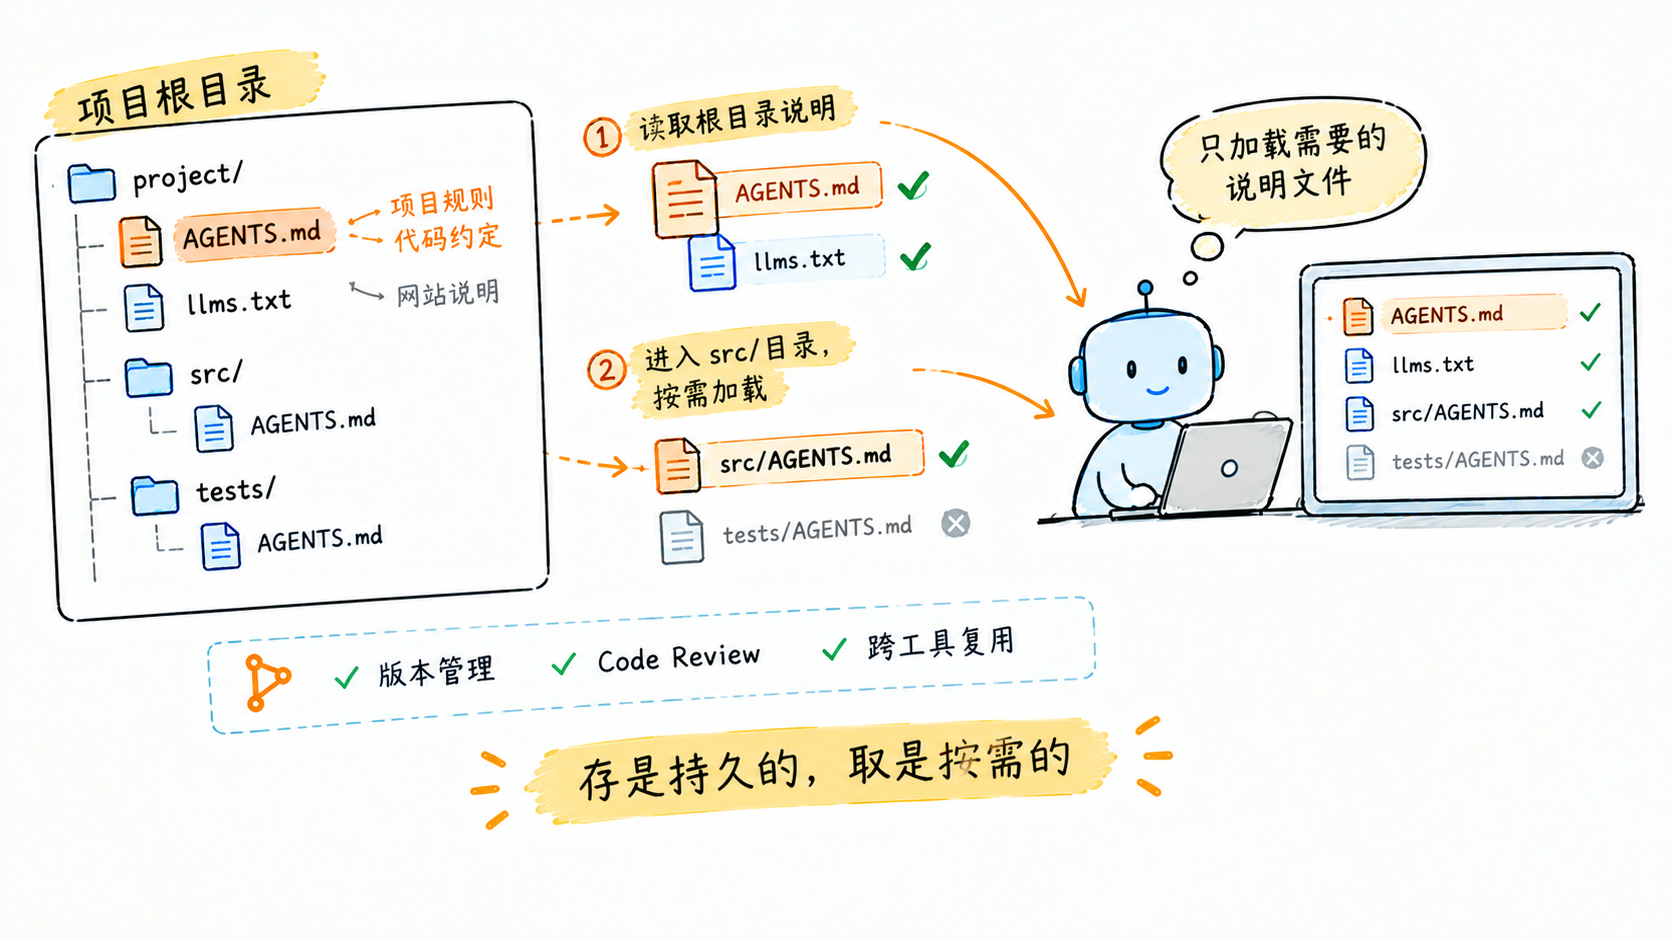
项目的规矩写成 AGENTS.md,放在仓库里,每个新会话自动读取;网站给爬虫和 agent 的说明写成 llms.txt,放在根目录。这些文件用 git 管理、可以 code review、跨工具通用。Claude Code 的作者在访谈里说过,CLAUDE.md 的起源就是用户自发写 markdown 让模型读,产品只是把用户行为收编了。
加载方式也很讲究:嵌套的 AGENTS.md 不在启动时全量灌入,而是工具读到哪个子目录,才注入哪个子目录的说明。存是持久的,取是按需的,这正好预告了后半篇的主题。
存的第二去处:跨会话记忆
文件系统存的是"写给模型看的说明",还有一类信息是"从对话里长出来的":你的偏好、项目的坑、上次任务的结论。这类信息存哪?
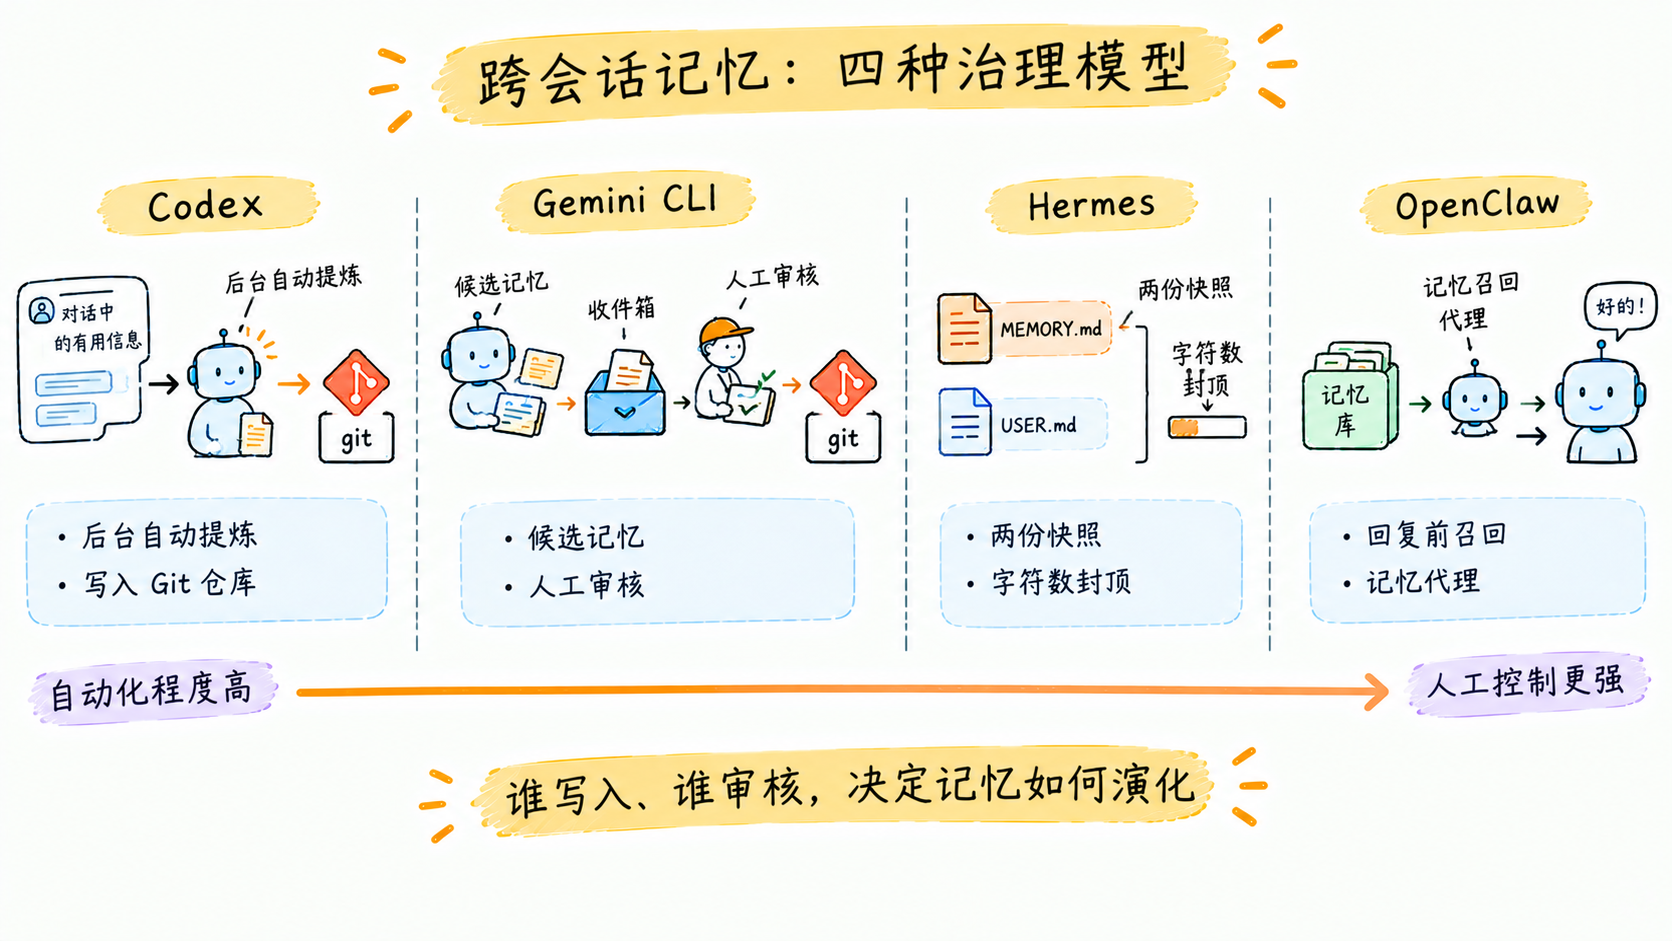
论文的观察是,压缩的方案各家已经收敛,记忆的写入路径才是新前线。四家给出了四种治理模型:
- Codex 最激进:后台子代理自动从会话里提炼记忆,写进一个 git 管理的仓库,全程无人参与;
- Gemini CLI 加了人审:提取子代理把候选记忆写进收件箱,用户看过才生效;
- Hermes 最克制:只允许两份字符数封顶的快照文件,会话中途写入不失效缓存;
- OpenClaw 在每次回复前先跑一个记忆召回代理。
谁写入、谁审核,决定了一个 agent 的"性格":全自动的记忆会自我强化偏差,全人工的记忆又懒得写。这个光谱现在还没收敛。
文件什么时候不够:数据库的进场条件
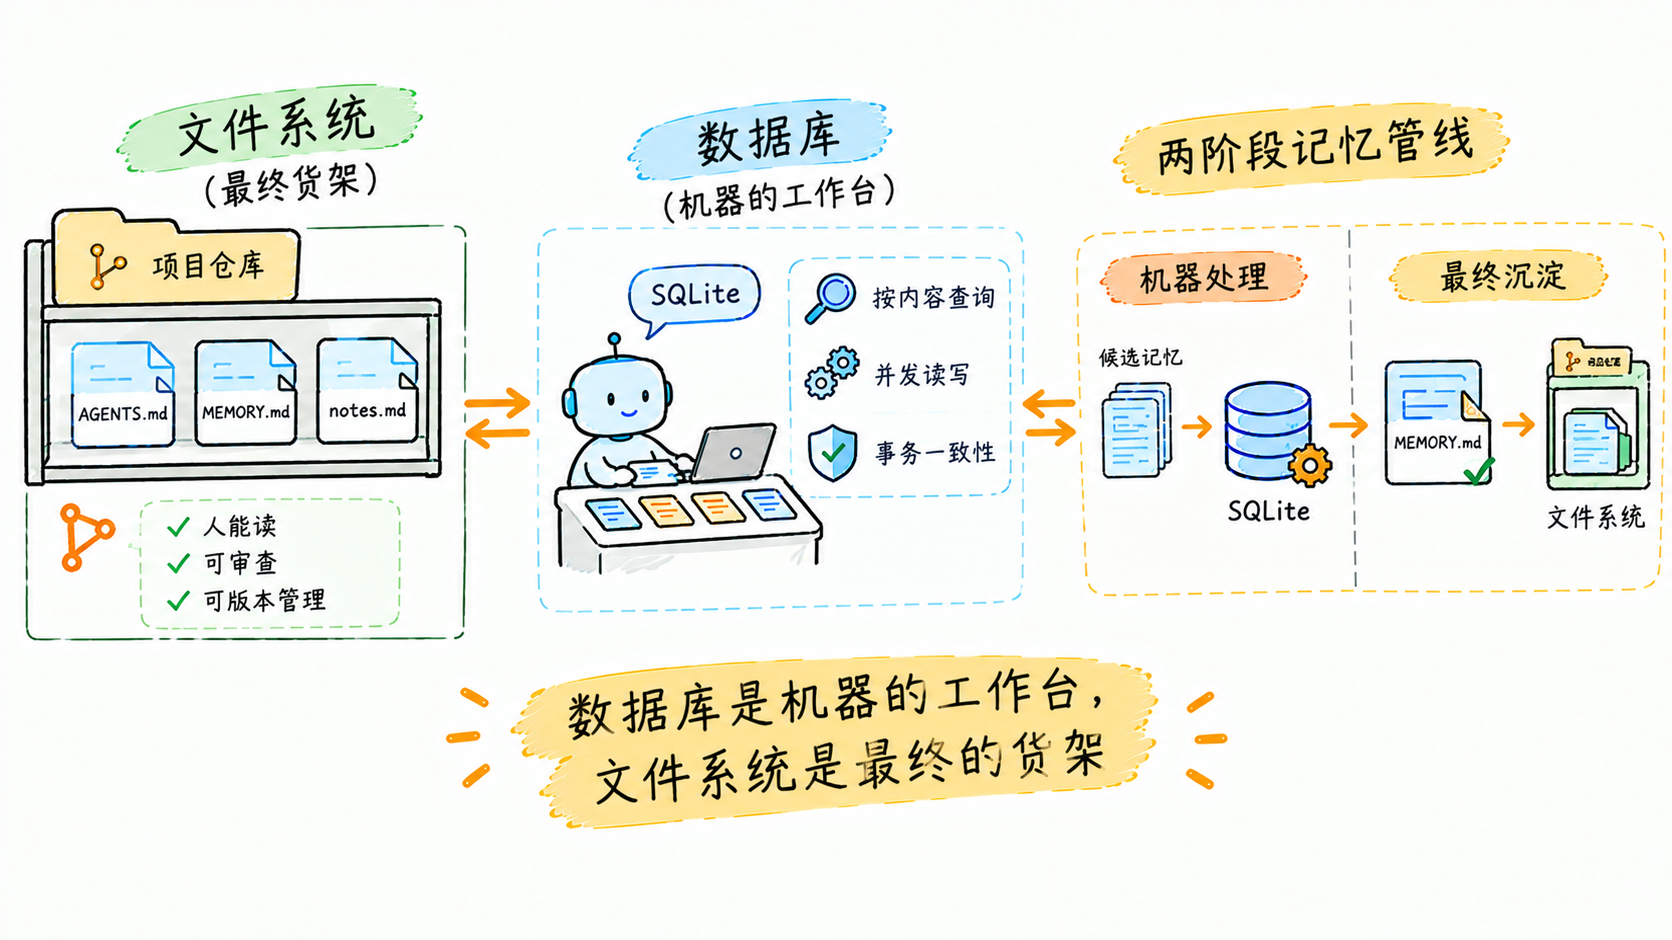
文件系统之外,还有个常见疑问:什么时候需要数据库?三条触发线。
一是要按内容查,不只是按路径读:文件是给"知道路径的人"用的,一旦要"找出所有提到某关键词的会话",就需要全文索引。二是多个进程并发读写:第 6 篇会讲到多个 agent 子进程协作,共享一块状态区,文件做并发写会出事,Hermes 的做法是拿 SQLite 当共享黑板。三是状态需要事务一致:权限授予这类记录,写一半崩了不能出现"半个授权"。
反过来也有反例:pi 的会话检索就是顺着 JSONL 文件线性扫,没有数据库,个人规模完全够用。最说明问题的是 Codex 的记忆管线,两段式:机器处理的阶段用 SQLite,最终沉淀的成果写回 git 管理的 markdown 文件。一句话概括分界线:数据库是机器的工作台,文件系统是最终的货架。
IMPORTANT: 上下文是工作内存,文件系统是硬盘。链一的全部概念,本质都是在管这两个存储之间的换入换出。
取:为什么 11 家没有一家用向量 RAG 读代码
存好了,怎么取?其实"取"分两类。
第一类是取回自己外置的:说明文件、记忆快照。这类量小,方案也基本收敛,文件就是方案,读文件就是取。真正有争议的是第二类:取用工作现场。代码仓库大到永远装不进上下文,agent 每次只能按需去读,用什么工具读,就是 RAG 之争发生的地方。
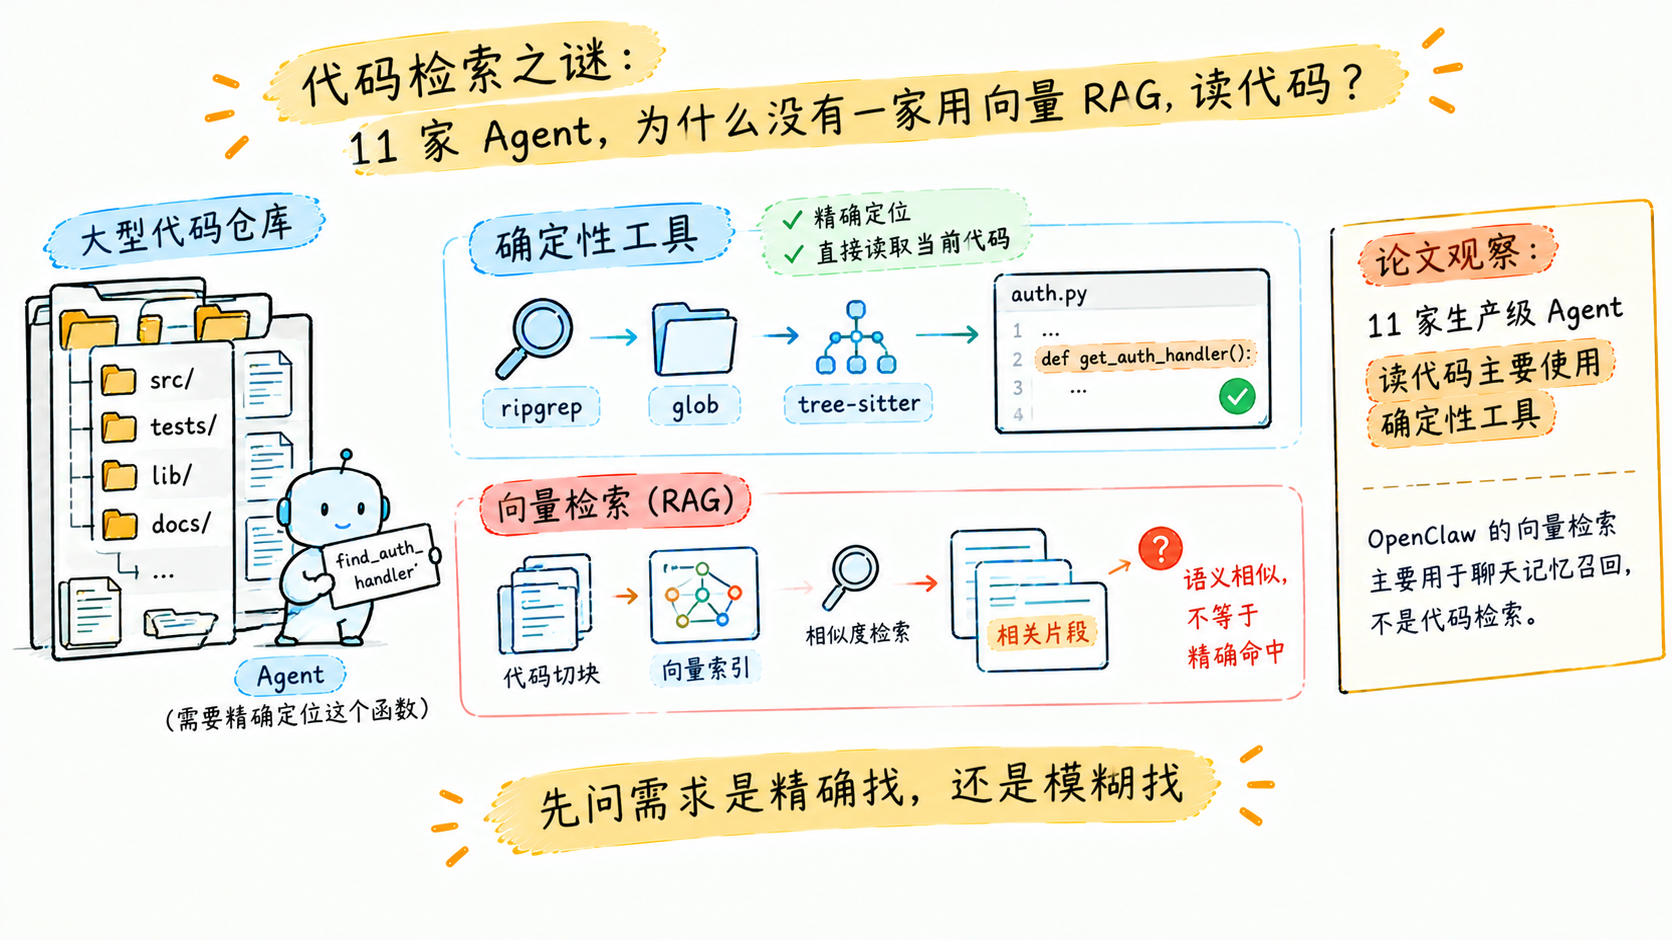
学过 LLM 应用开发的人,大概率默认这里的答案是 RAG:切块、向量化、建索引、相似度检索。
但论文最反直觉的发现是这个:11 家生产级 Agent,读代码没有一家用向量检索,全部是 ripgrep、glob、tree-sitter 这类确定性工具。这个结论经受了两轮复核:语料扩到三倍、隔三个月重审,结果不变。
把各家的方案摆出来,清一色"土办法":Claude Code 内置 ripgrep 关键词搜索;Codex 是 Rust 原生文件搜索;Gemini CLI 捆绑 ripgrep 加 glob;Aider 用 tree-sitter 抽符号建仓库地图;Hermes 的会话检索用 SQLite 全文索引,代码里明确注释"没有任何 LLM 调用";pi 自动下载 ripgrep 和 fd,grep、find 两个工具背后就是它们。
唯一的例外是 OpenClaw,默认开了向量检索。但用途是聊天记忆的召回,不是读代码。
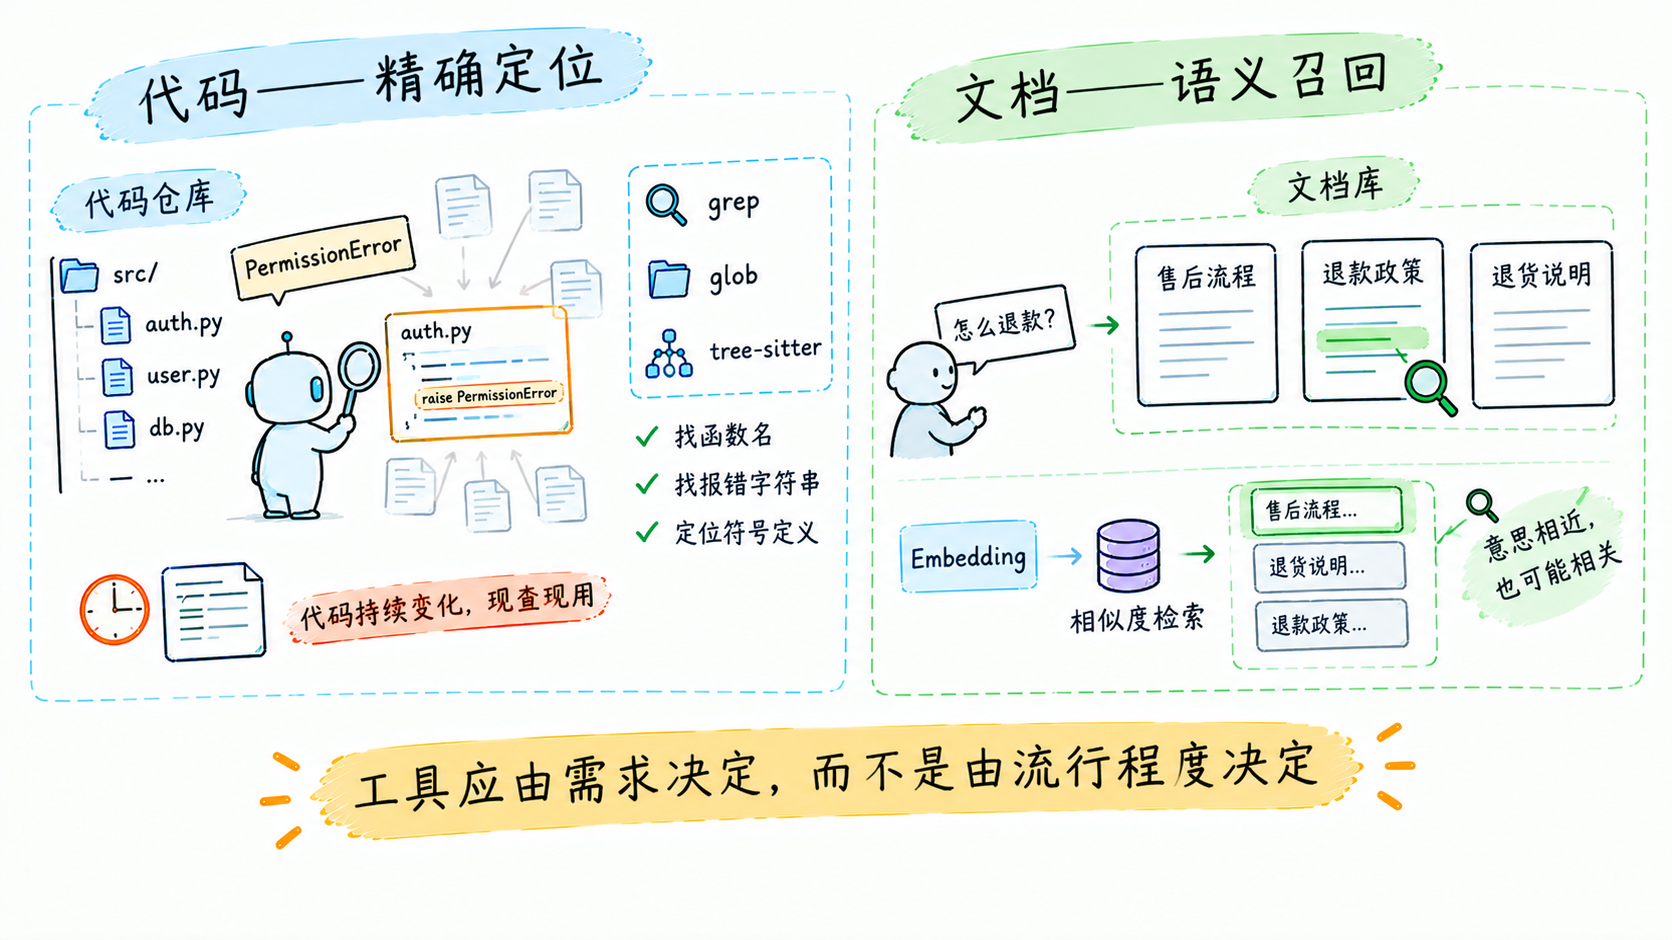
原因不神秘,是需求不匹配。查文档的问题是"意思相近":问"怎么退款",要召回写着"售后流程"的段落,这是 embedding 的主场。查代码的问题大多是"精确定位":找一个函数名、一个报错字符串在哪,grep 是精确命中,embedding 反而引入模糊。而代码里真正需要结构理解的部分,有更好的工具:文件路径是现成索引,tree-sitter 能解析语法树,语言服务器能直接回答"这个符号在哪定义"。
向量索引还有个结构性劣势:代码分钟级地在变,索引建好那一刻就开始过期。grep 每次现查,永远拿到当下这一秒的代码。
按需取用是一整套哲学
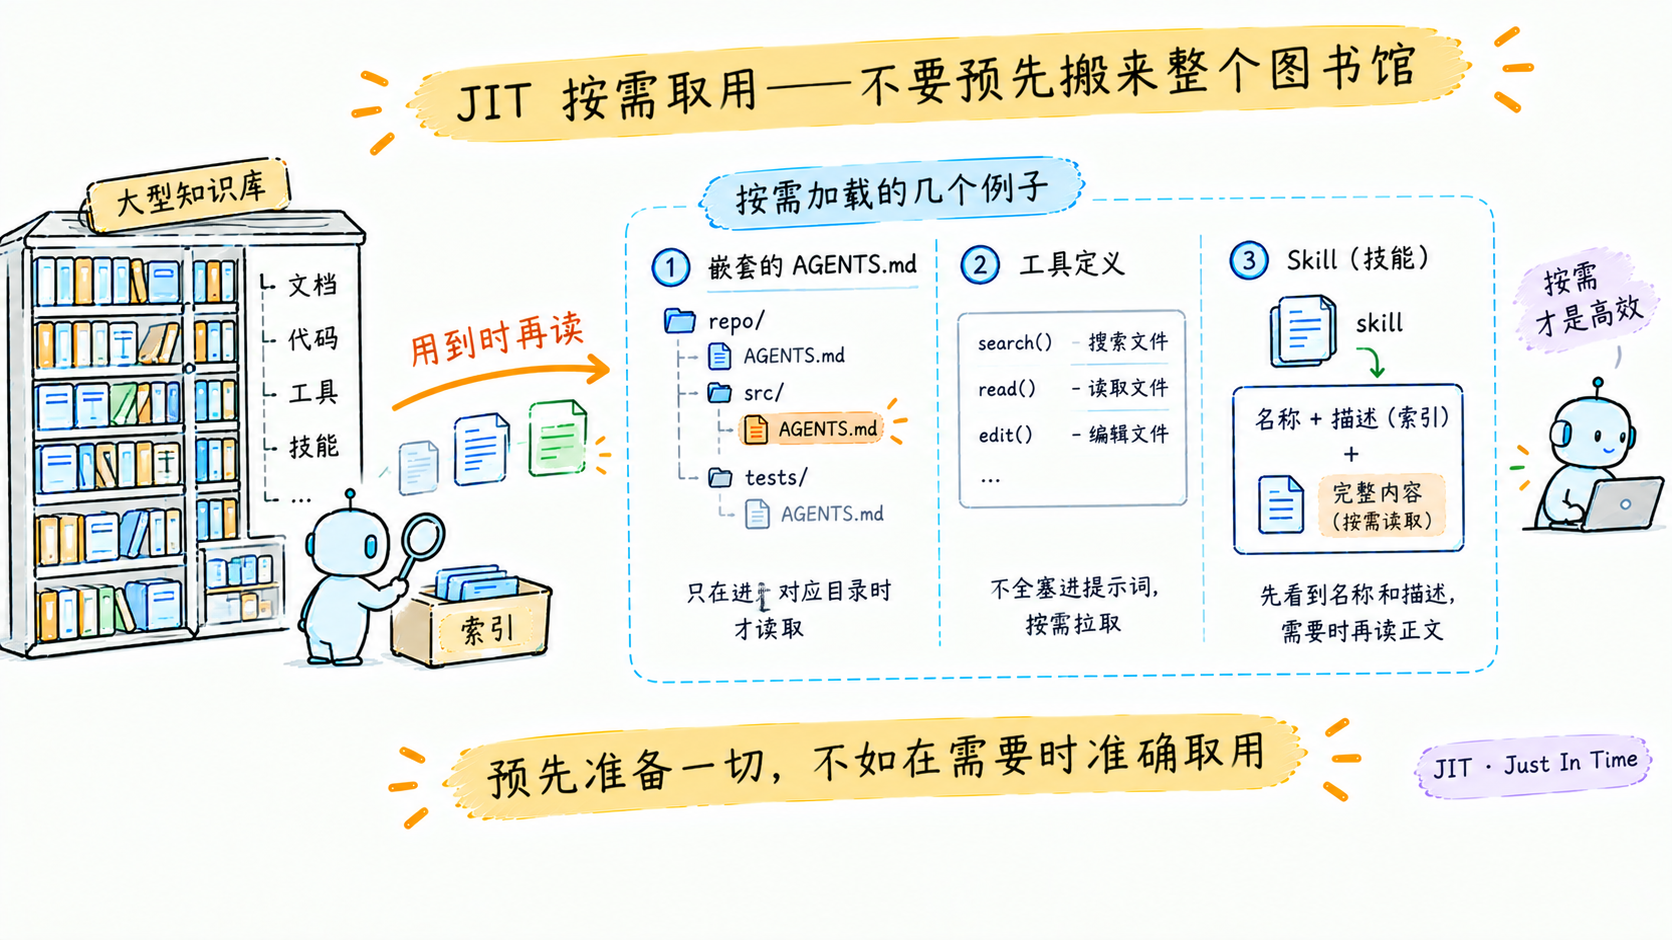
回看刚才的争论,它其实是一道更普遍的选择题的特例:信息是预先准备好(建索引、提前加载),还是用的时候现找(现查、现读)。向量 RAG 是预建派的代表,ripgrep 是按需派的代表。按需这一派有个来自制造业的名字:JIT(just-in-time),用到的时候才做。
这道选择题也不止出现在检索里。Anthropic 在上下文工程那篇文章里给过一个类比:人类也不背下整个图书馆,而是用文件系统、收件箱、书签这类外部组织系统,需要时再取。落到 harness 的实现里,按需取用无处不在:嵌套的 AGENTS.md 读到才注入(这篇开头讲过),工具定义不全塞进提示词、用搜索按需拉取,skill(打包好的"教法"文件,链四的主角,到时详讲)只在提示词里放名称和描述的索引、正文用到才读。
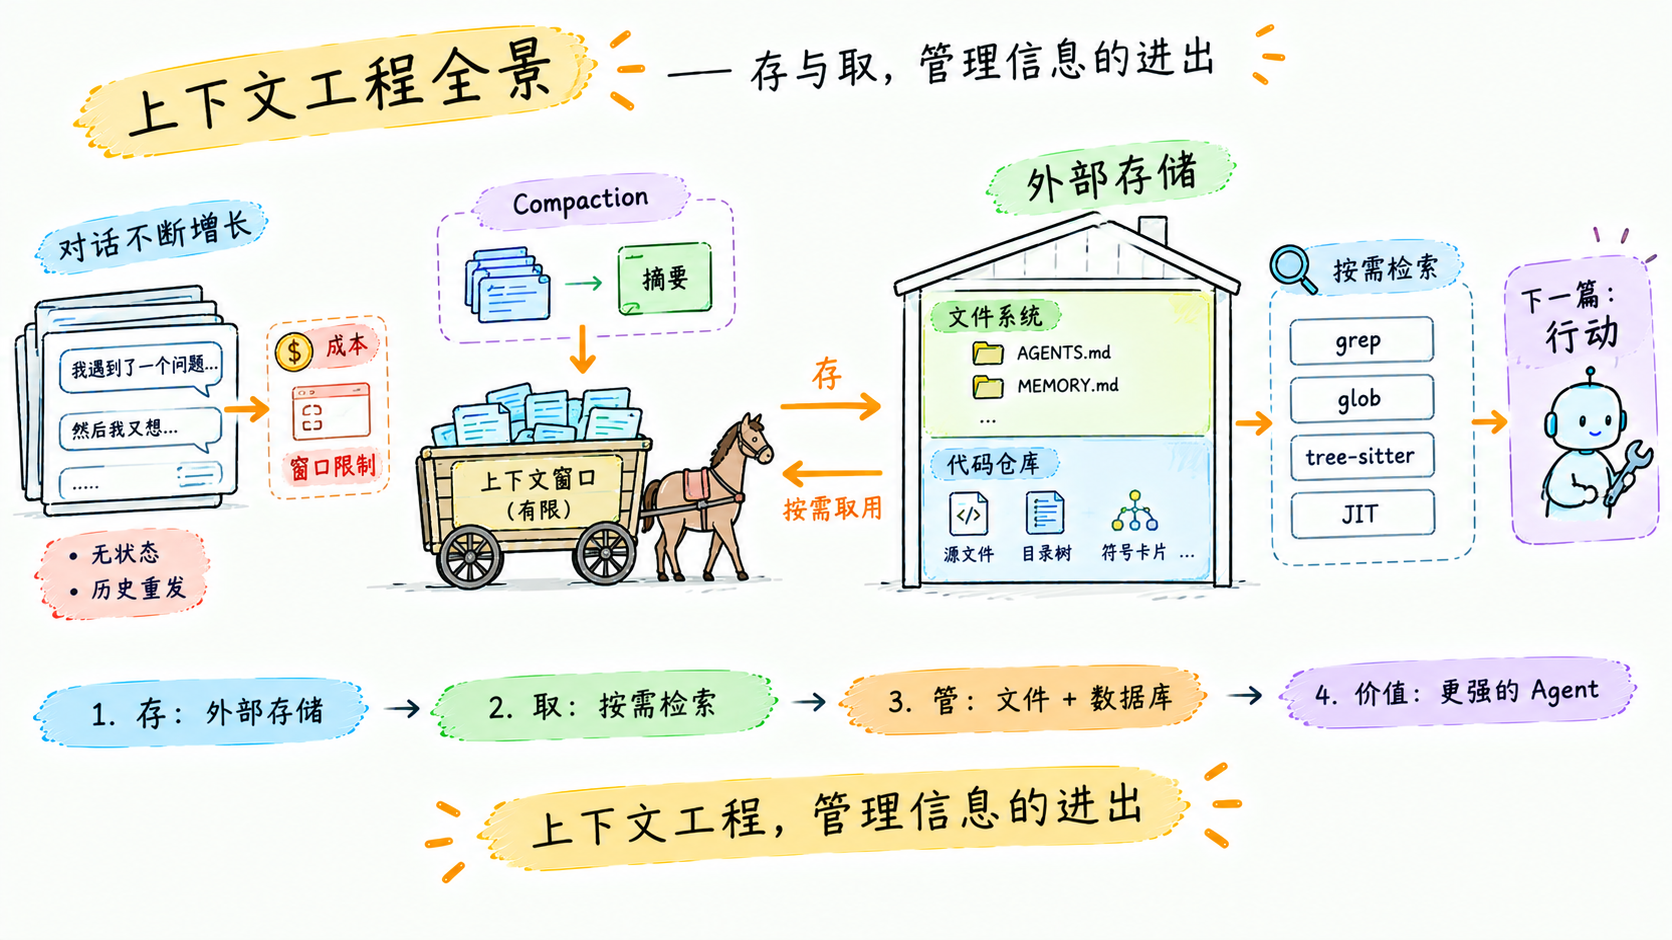
回头串链一的全景:无状态导致每次重发历史,历史撞上成本和窗口两堵墙,墙内用 compaction 压缩,墙外用外置加按需取用。上下文工程这个学科,管的就是这一池子水的进出。
边界:RAG 什么时候仍然对
这个结论不能扩大化。
RAG 照样是对的,只要满足两个条件:语料是非结构化文本(文档、聊天记录、知识库),且更新不频繁到分钟级。私有文档问答、企业知识库、聊天记忆召回,都是它的主场。
错的不是 RAG,是不分场景地把它当成默认第一步。那 11 家的判断可以浓缩成一句话:先问需求是精确找还是模糊找,再决定用 grep 还是向量。
写在最后
链一到这篇收尾。无状态,所以历史重发;重发又贵又受窗口限制,所以压缩;压缩有损,所以重要的信息外置;外置之后,按需取用。内存和硬盘之间的换入换出,就是上下文工程的全部。
下一篇换一条链。模型只会输出文本,那它是怎么"动手"干活的?从 ReAct 讲到 Function Calling,这条路第一次没能走稳。
参考资料
- Harness Engineering: Anatomy, Architecture, and Evolution of Coding Agents(记忆治理见 Observation 5,检索方案见 §13.2,双缺席见 Observation 9)
- Effective context engineering for AI agents - Anthropic Engineering(JIT 与文件系统类比)
- 本系列第 2 篇:(2)Compaction:上下文满了之后