
(2)Compaction:上下文满了之后
写在前面
让 agent 干过长时间任务的人,多半见过这个现象:干着干着,它开始忘事。忘了最初的目标,忘了前面已经试过什么,甚至忘了自己改过哪些文件。
上一篇讲过原因:无状态,历史每次全量重发,窗口有硬顶,而且装得下不等于用得好。历史涨到窗口边上,问题就从"贵"变成了"崩"。
这篇讲生产级 harness 的标准应对:compaction,上下文压缩。那篇解剖 11 个系统的论文里,七家用的都是同一个思路,细节上却各不相同,对照着看很有意思。
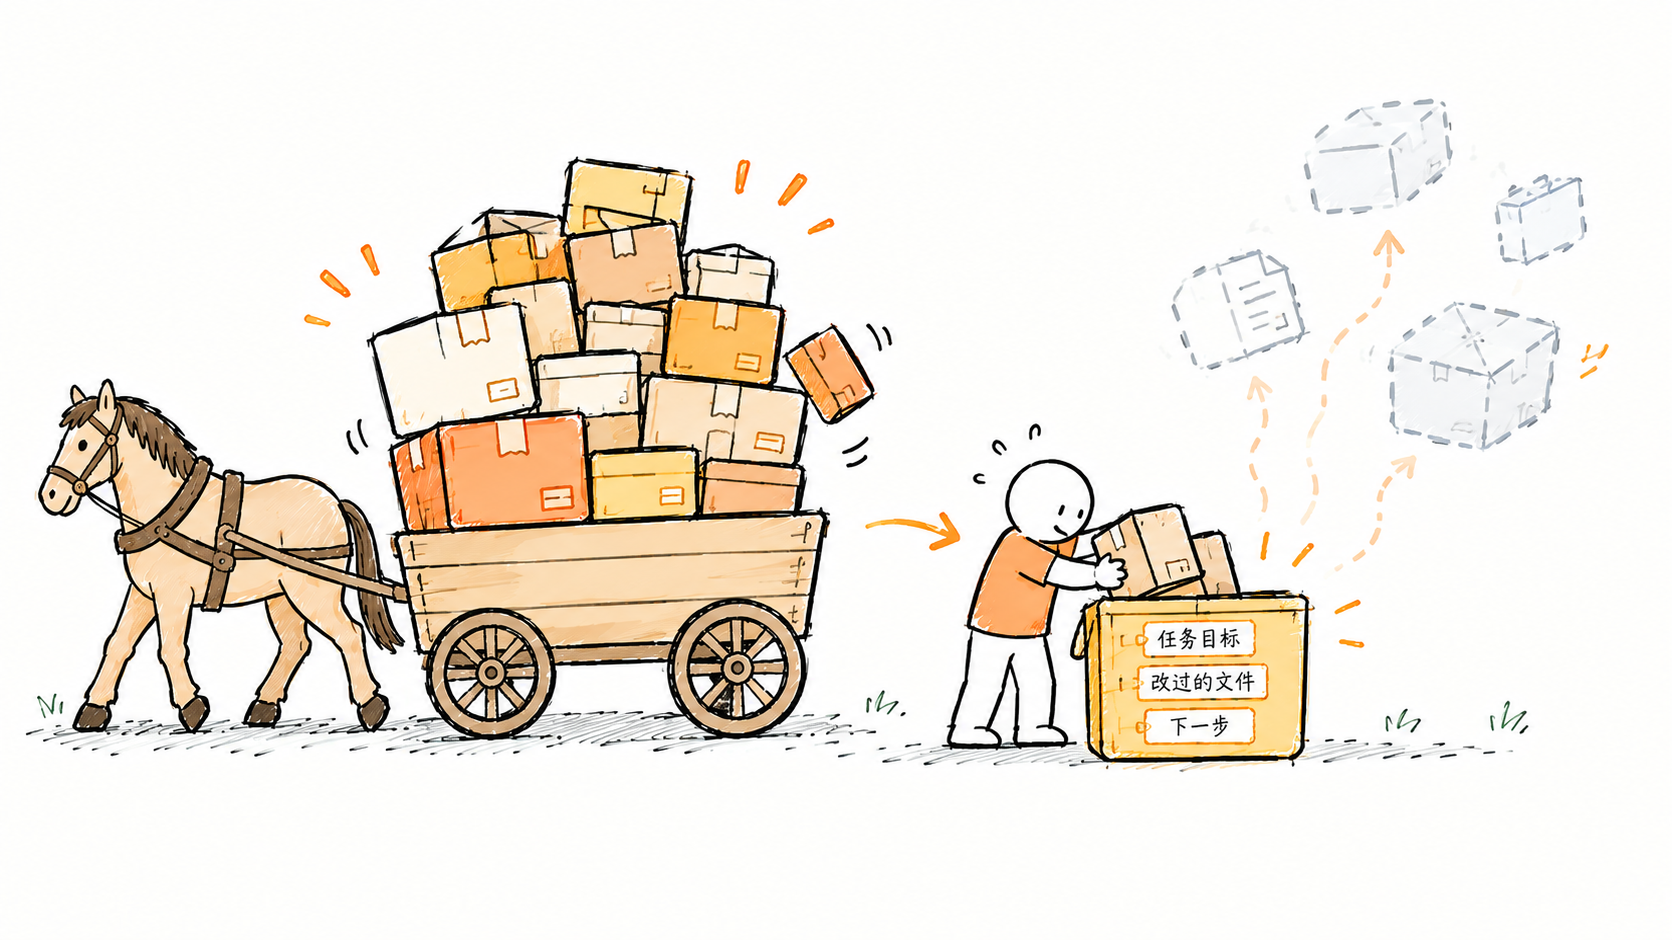
上下文被稀释:不止是装不下
先明确一点:压缩要解决的不只是"装不下"。
随着上下文变长,模型的指令遵循能力会下降,早期信息的影响越来越弱。Anthropic 在上下文工程那篇文章里描述过这个现象,用的词是 context rot,直译是"上下文腐烂"。但我认为更准确的描述是稀释:内容本身没有变,一字不少地躺在上下文里,变的是模型对它的注意力。新内容越多,早期信息被分到的注意力就越少,像一杯茶不断兑水,茶还是那些茶,味道越来越淡。窗口还没满,性能已经在掉。
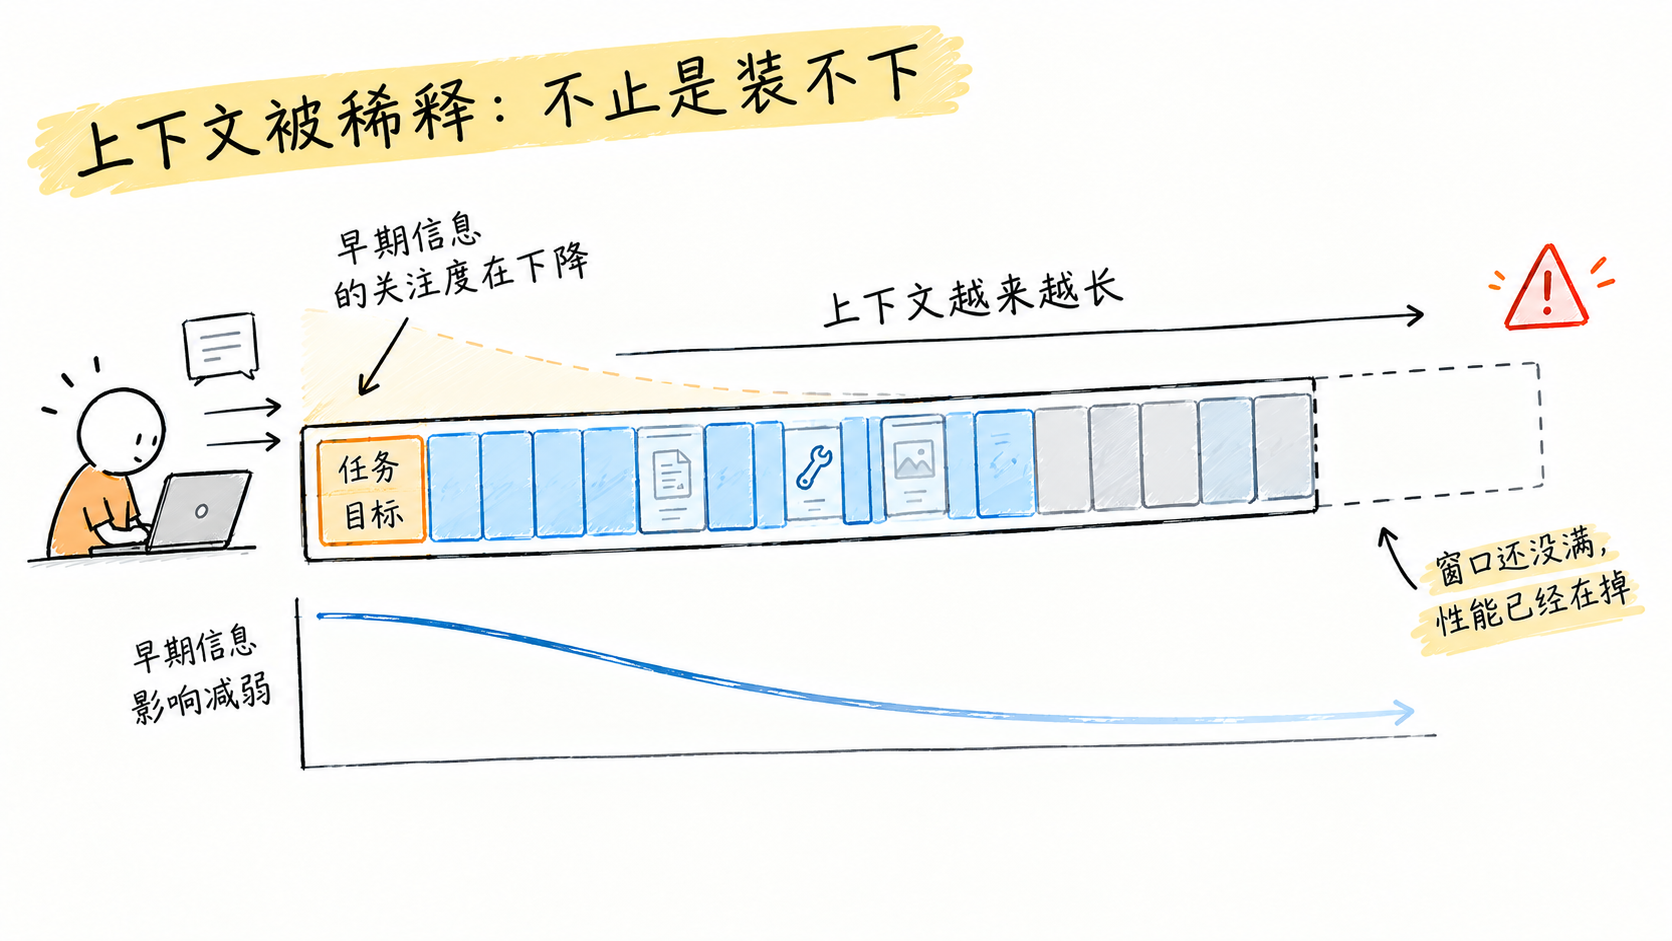
所以触发压缩的时机不是"满了才压",而是提前量。判断标准也很实际:早期决策还在不在、目标还记得准不准。一个 agent 改了二十个文件之后忘了任务目标,这不是模型变笨了,是目标被二十个文件的工具输出淹没了。
IMPORTANT: 长会话的问题不是容量不够,是信噪比下降。压缩的目标不是省空间,是把任务状态从噪音里捞出来。
压缩的标准做法
基本套路七家一致,都是阈值触发加 LLM 摘要:
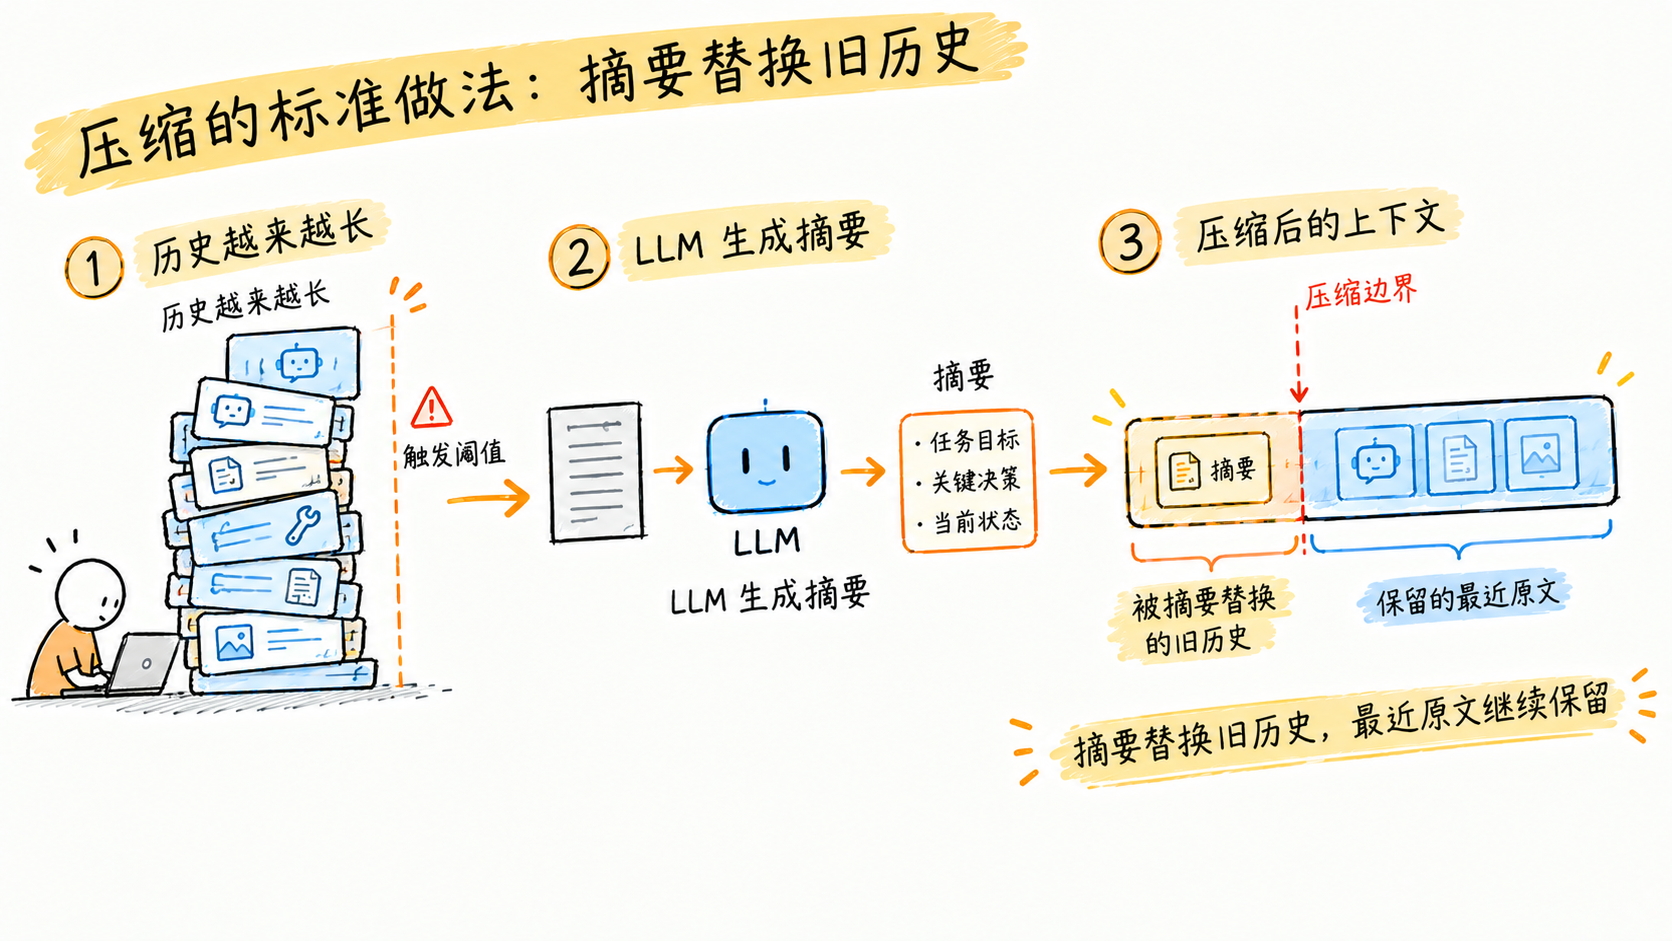
- 设一个阈值,留出提前量;
- 触发时,把历史交给模型生成一份摘要;
- 用摘要替换旧历史,保留最近一段原文。
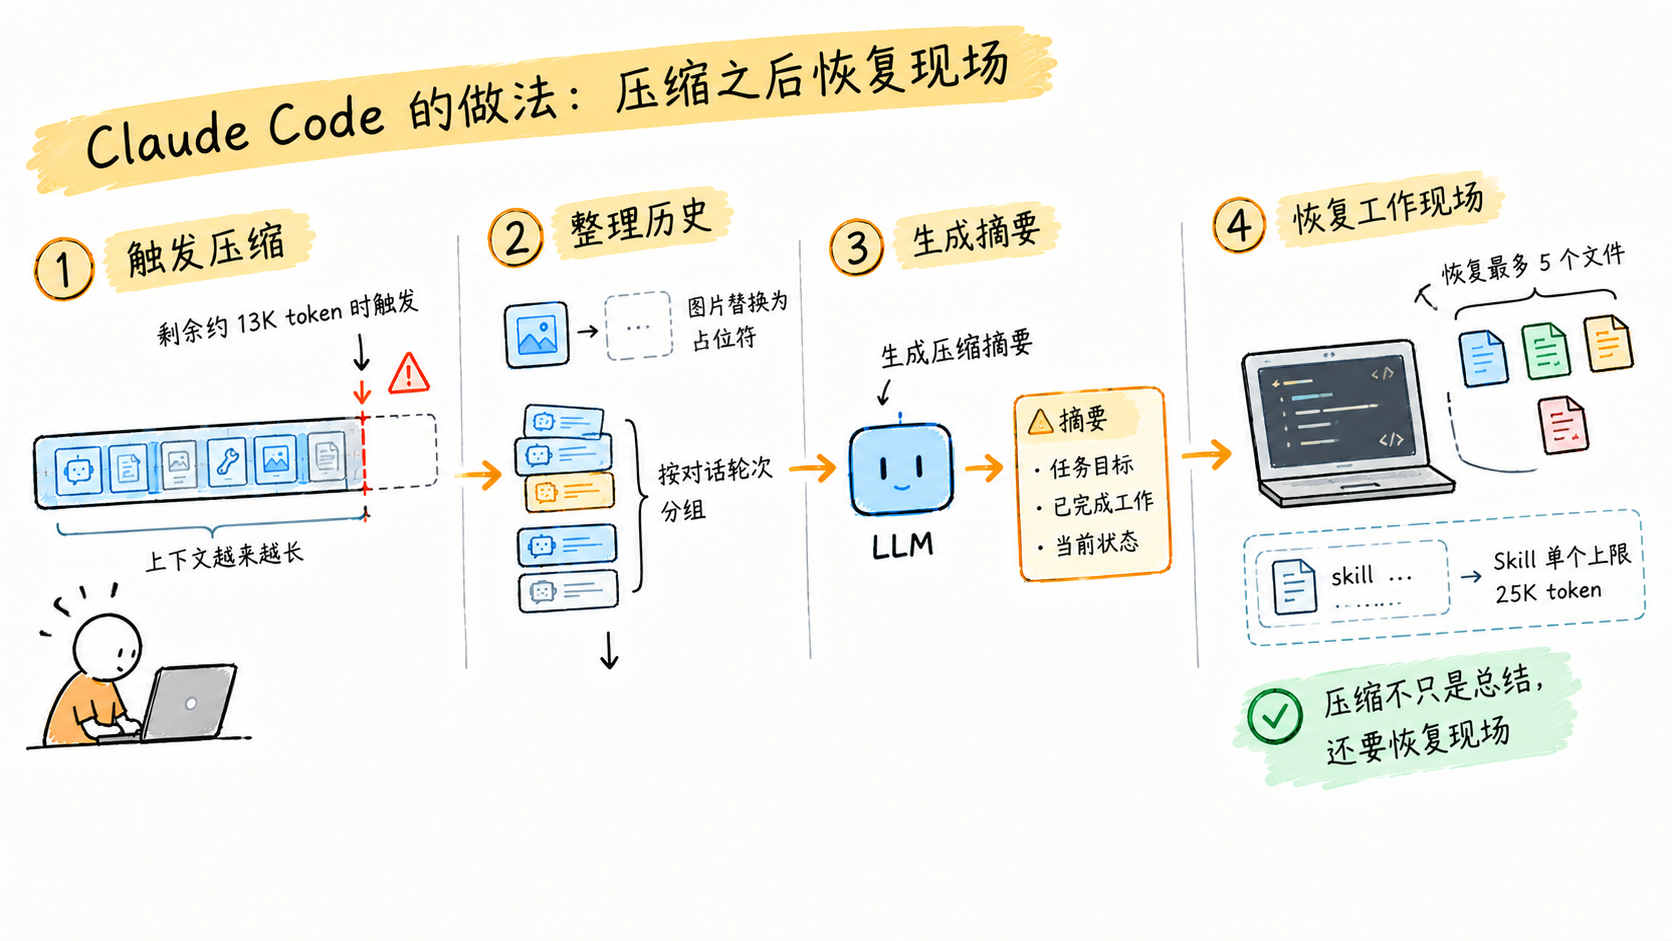
拿 Claude Code 举例。它的压缩在剩余 token 距离窗口上限还有约 13000 时触发。压缩过程会先把消息里的图片剥掉(替换成占位符),按对话轮次分组,让模型生成摘要,然后画一条压缩边界,边界之前的历史被摘要替换。
还有两个善后细节:压缩后会把最多 5 个文件重新读回来(预算 50000 token),因为压缩把"刚才在改哪个文件"的现场也压没了,得补;skill 的内容也截断到单个 25000 token 以内。
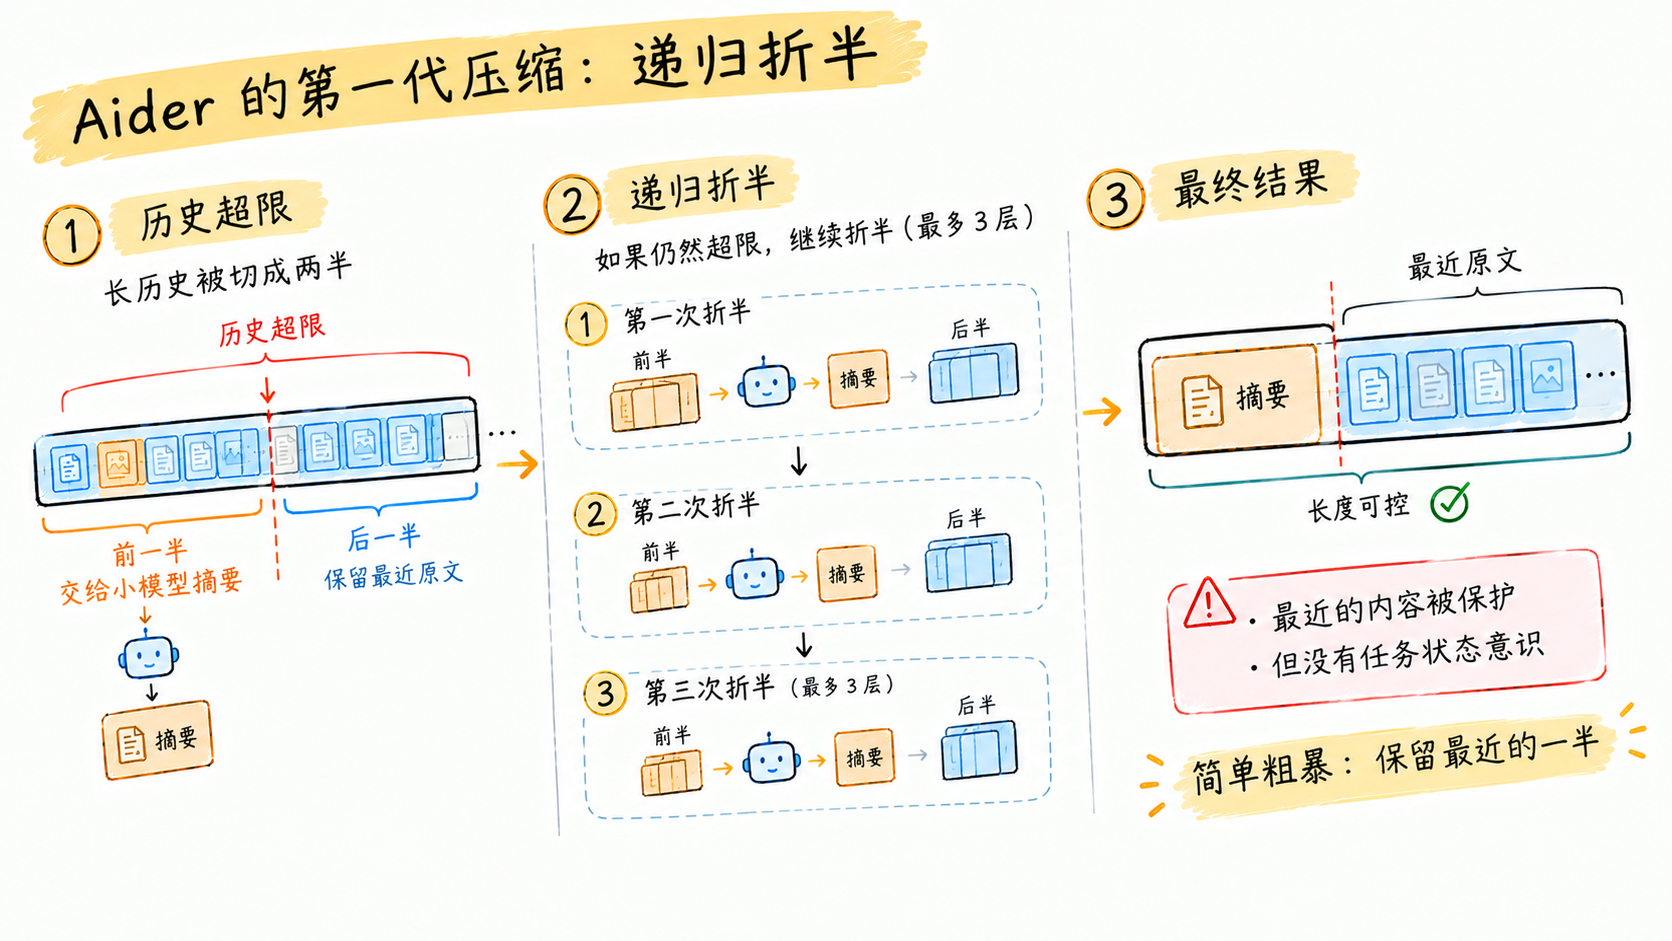
第一代的做法可以看 Aider,2022 年的递归折半:历史超限就砍成两半,保留最近的一半,前一半让一个便宜的小模型摘要,还不够就递归,最多三层。简单,但"最近的一半"是无差别保护的,没有任务状态的意识。
五家实现,五个侧重
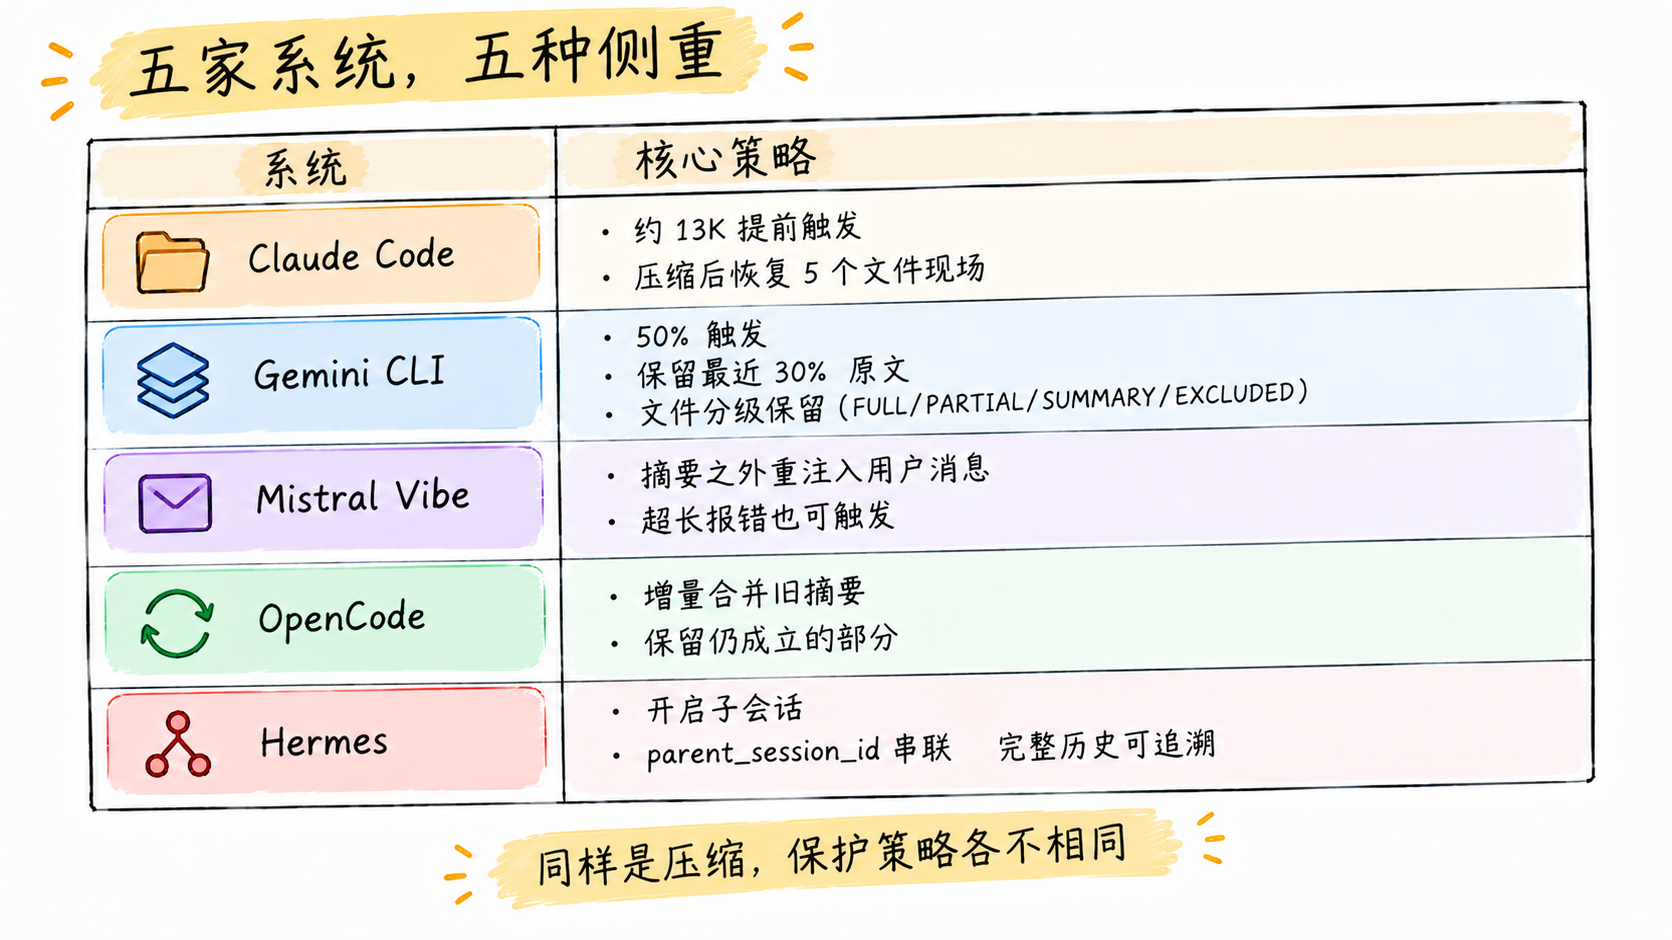
论文里七家做阈值压缩的,细节差异值得挨个看:
| 系统 | 特色 |
|---|---|
| Claude Code | 13K 提前量;压缩后恢复 5 个文件现场 |
| Gemini CLI | 50% 触发,保留最近 30% 原文;对文件按 FULL/PARTIAL/SUMMARY/EXCLUDED 分级,比"压/不压"二值细 |
| Mistral Vibe | 压缩后的状态是个"信封":摘要之外把之前的用户消息重新注入,保证最初的任务目标在重启后存活;同一套逻辑还会在撞上超长报错时被动触发 |
| OpenCode | 增量合并:摘要时把上一份摘要一起传回去,"仍然成立的部分保留,过期的部分删掉",而不是从头重摘 |
| Hermes | 最特别:压缩不是改写历史,是结束当前会话、开一个子会话,用 parent_session_id 串起来。历史一个字都不销毁,检索时跨谱系去重 |
我最喜欢 Hermes 这个设计。它把"压缩"和"会话管理"合并成了一个机制:对模型来说每次压缩都是一次干净的新开始,对人来说完整的审计记录都在。代价是检索要做跨会话,实现复杂一些。
Pi 的做法介于两者之间:会话本身是一棵树,压缩时保留最近 20000 token 原文,摘要采用迭代合并(和 OpenCode 同思路),另外留了一个 hook,让扩展可以否决或替换压缩结果。
TIP: 增量合并(把旧摘要传回去一起合并)比从头重摘更能保住早期决策。自己写 harness 的话,这是最值得抄的一个细节。
压缩的代价
压缩不是免费的,代价有两个。
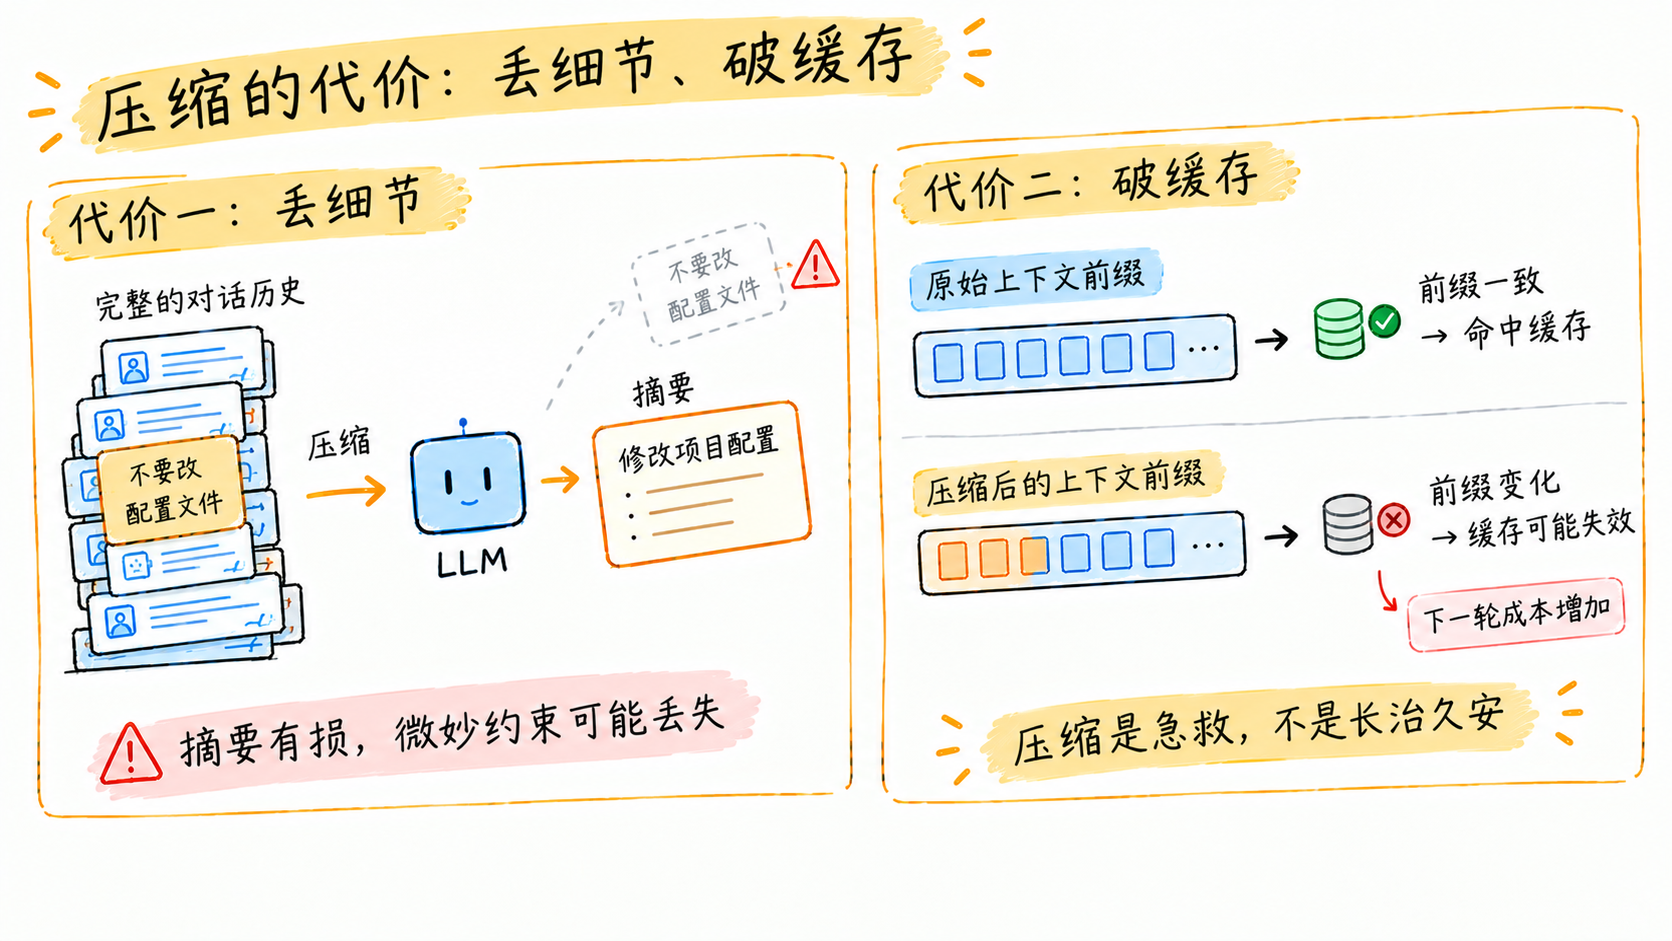
一是丢细节。摘要必然有损,早期对话里的微妙约束("不要动那个配置文件")可能被摘掉。所以各家都在"保护什么"上做文章:保护最近尾段、保护前几条消息、重注入用户原始消息,方向都是一样的,压缩不能把任务状态压没了。
二是破缓存。上一篇讲过 prompt caching 靠"前缀完全相同"命中。压缩把历史改写了,前缀一变,缓存全部失效,下一轮要全价。这就是为什么触发时机要留提前量、要加缓冲:压缩本身是个昂贵动作,不能频繁做。
这两个代价指向同一个结论:压缩是急救,不是长治久安。真正重要的信息,不应该只活在对话历史里。放到哪里、怎么取回来,是下一篇的事。
pi 里的开关
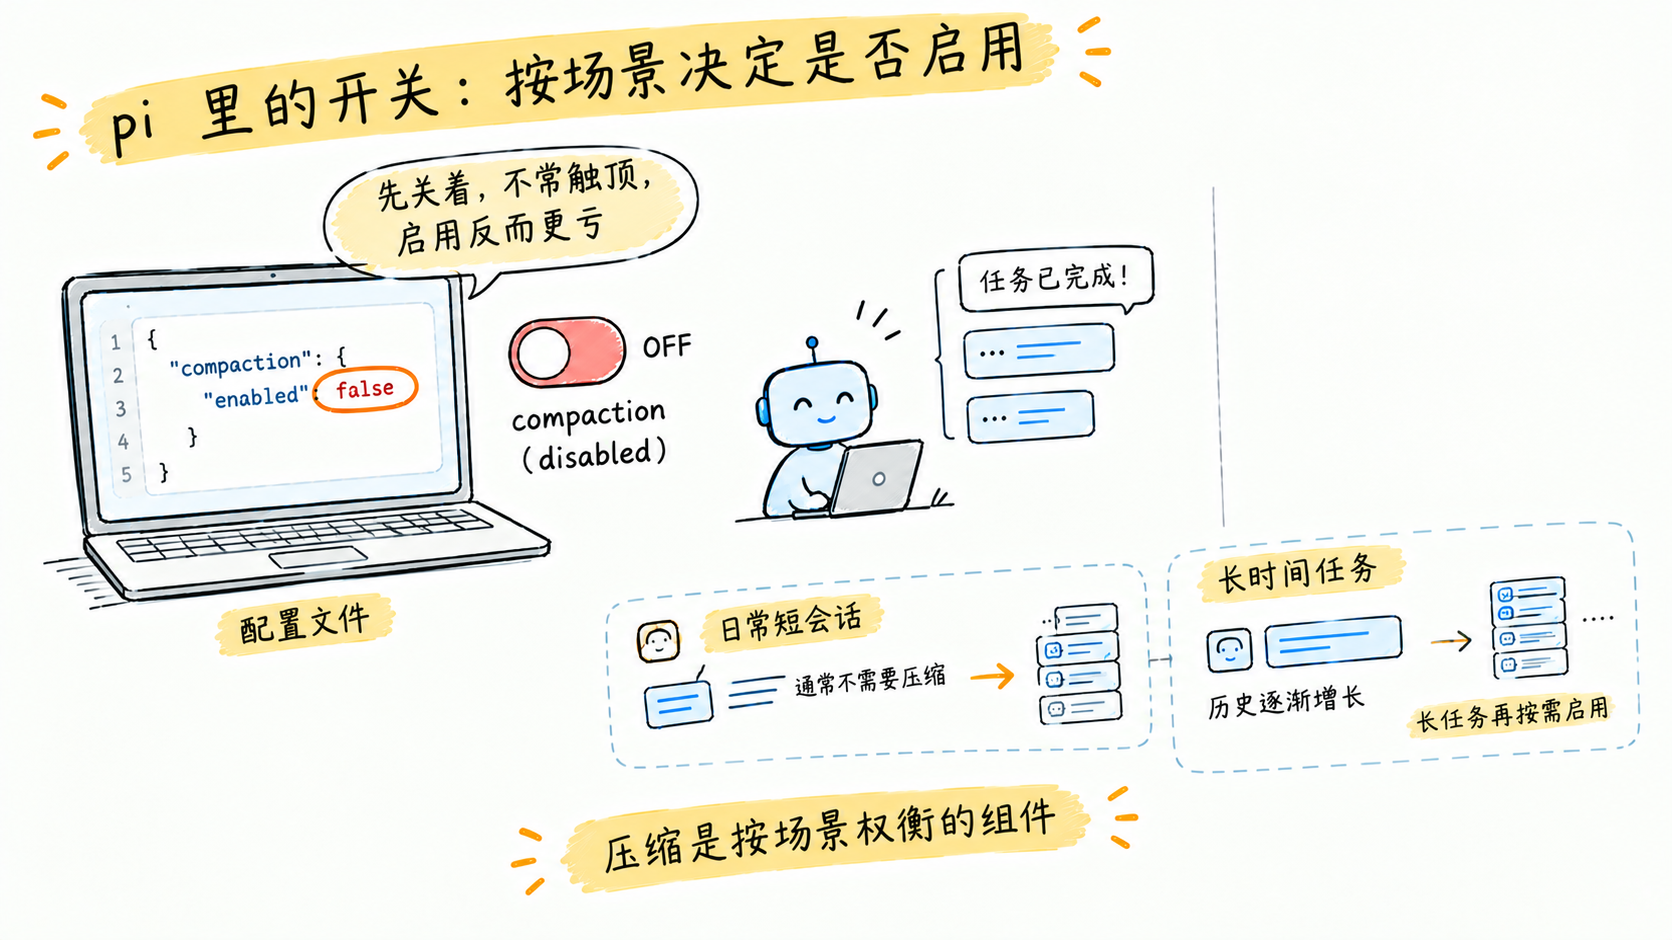
回到第 0 篇选定的实物 pi。它的压缩是可配置的,我的配置文件里现在写着:
"compaction": {
  "enabled": false
}
关着。不是因为否定压缩,是日常会话很少长到触顶,压一次的缓存代价反而更亏。真跑长任务时再开。这本身就是个说明:压缩是 harness 里一个要按场景权衡的组件,不是默认正义。
写在最后
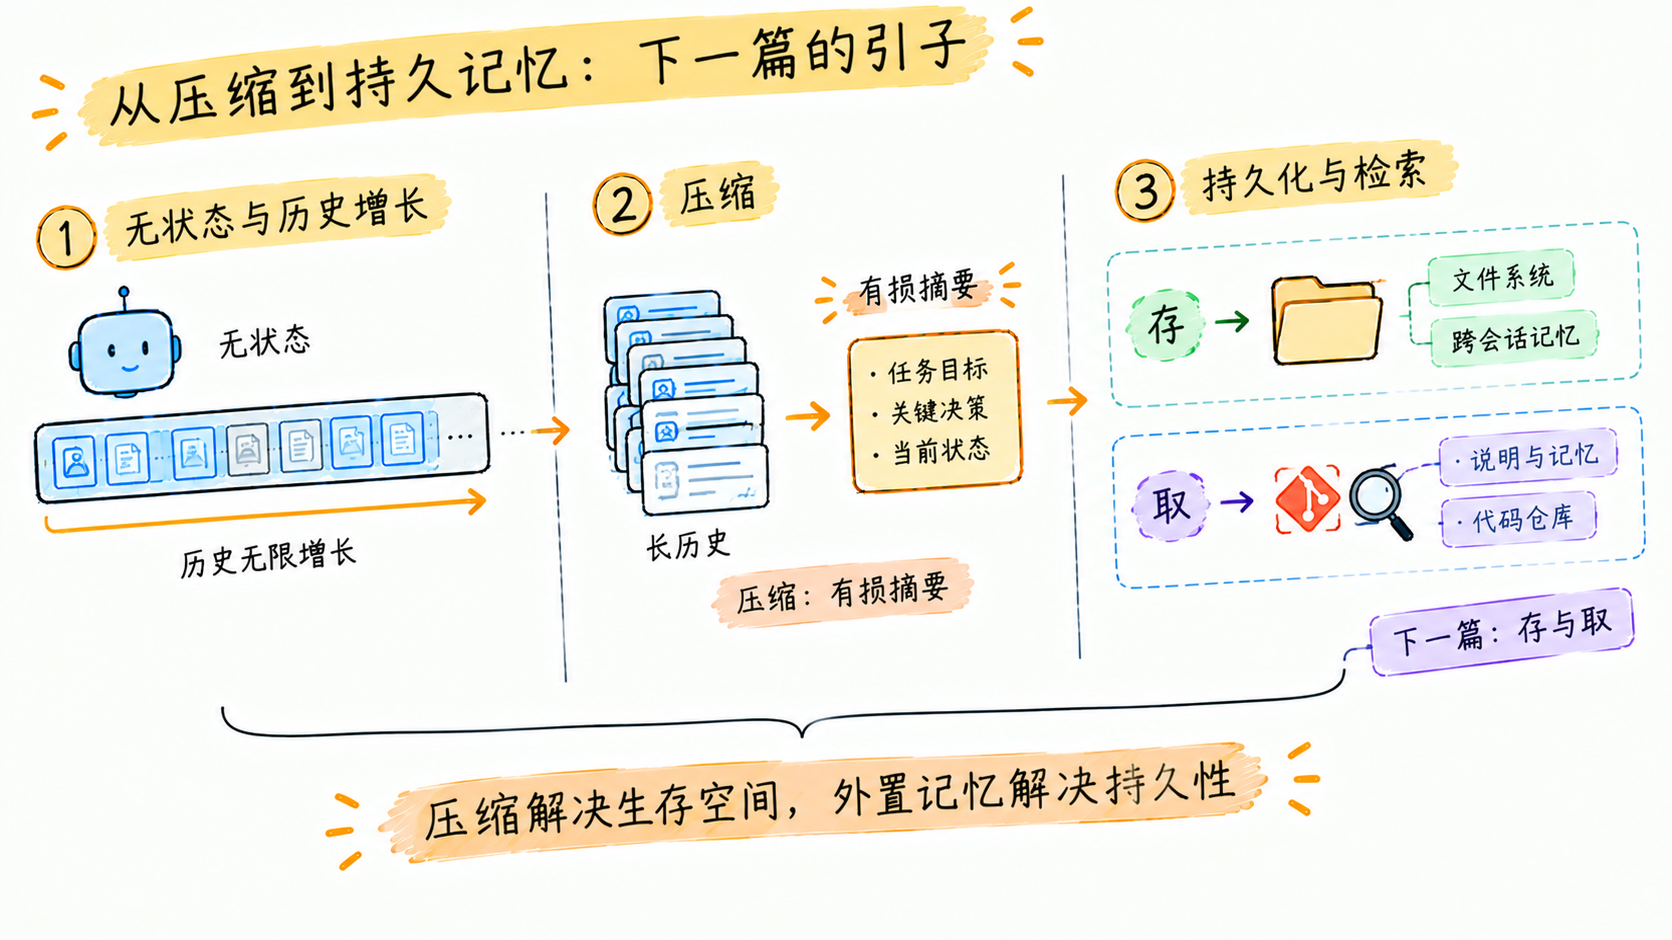
把因果线接上:无状态导致历史无限增长,窗口和信噪比给出硬约束,压缩用有损摘要换生存空间,七家系统在"保什么、怎么保"上收敛又分化。
但压缩解决不了信息的持久性问题。"装不下就放外面"其实包含两个子问题:重要的东西放在外面哪里,以及要用的时候怎么取回来。
下一篇把这两个问题一起讲完。存,主要靠文件系统和跨会话记忆。取,其实分两类:取回自己外置出去的说明和记忆,以及取用本来就装不下的代码仓库。第二类正好是一个悬案的现场:为什么那 400 万行源码里,没有一家 agent 用向量 RAG 读代码。
参考资料
- Harness Engineering: Anatomy, Architecture, and Evolution of Coding Agents(§9 记忆与上下文管理,本文五家实现细节均出自此)
- Effective context engineering for AI agents - Anthropic Engineering(context rot 的出处)
- 本系列上一篇:无状态:一切的起点