
(0)Agent 概念太多,先理清它们为什么出现
写在前面
最近半年我在学 Agent 相关的东西,一个直观感受是名词太多:MCP、skill、compaction、subagent、prompt caching、context engineering……每个词单查都能查到定义,查完还是不知道它们彼此什么关系。
市面上的教程大多是并列式讲法:一个概念一节,像新华字典。我把中英文的资料翻了一圈,基本都这样。
转机来自两处。一是读到了一篇解剖 11 个生产级 agent、共 400 万行源码的论文,二是自己天天泡在一个真的 harness(pi)里写扩展、配技能。两边的经验指向同一件事:这些概念不是并列的,是因果的。每个概念都是上一个概念留下的坑的回应。
所以我打算写一个系列,沿着"为什么"把 Agent 领域走一遍。这篇是第 0 篇,先给一张总地图。
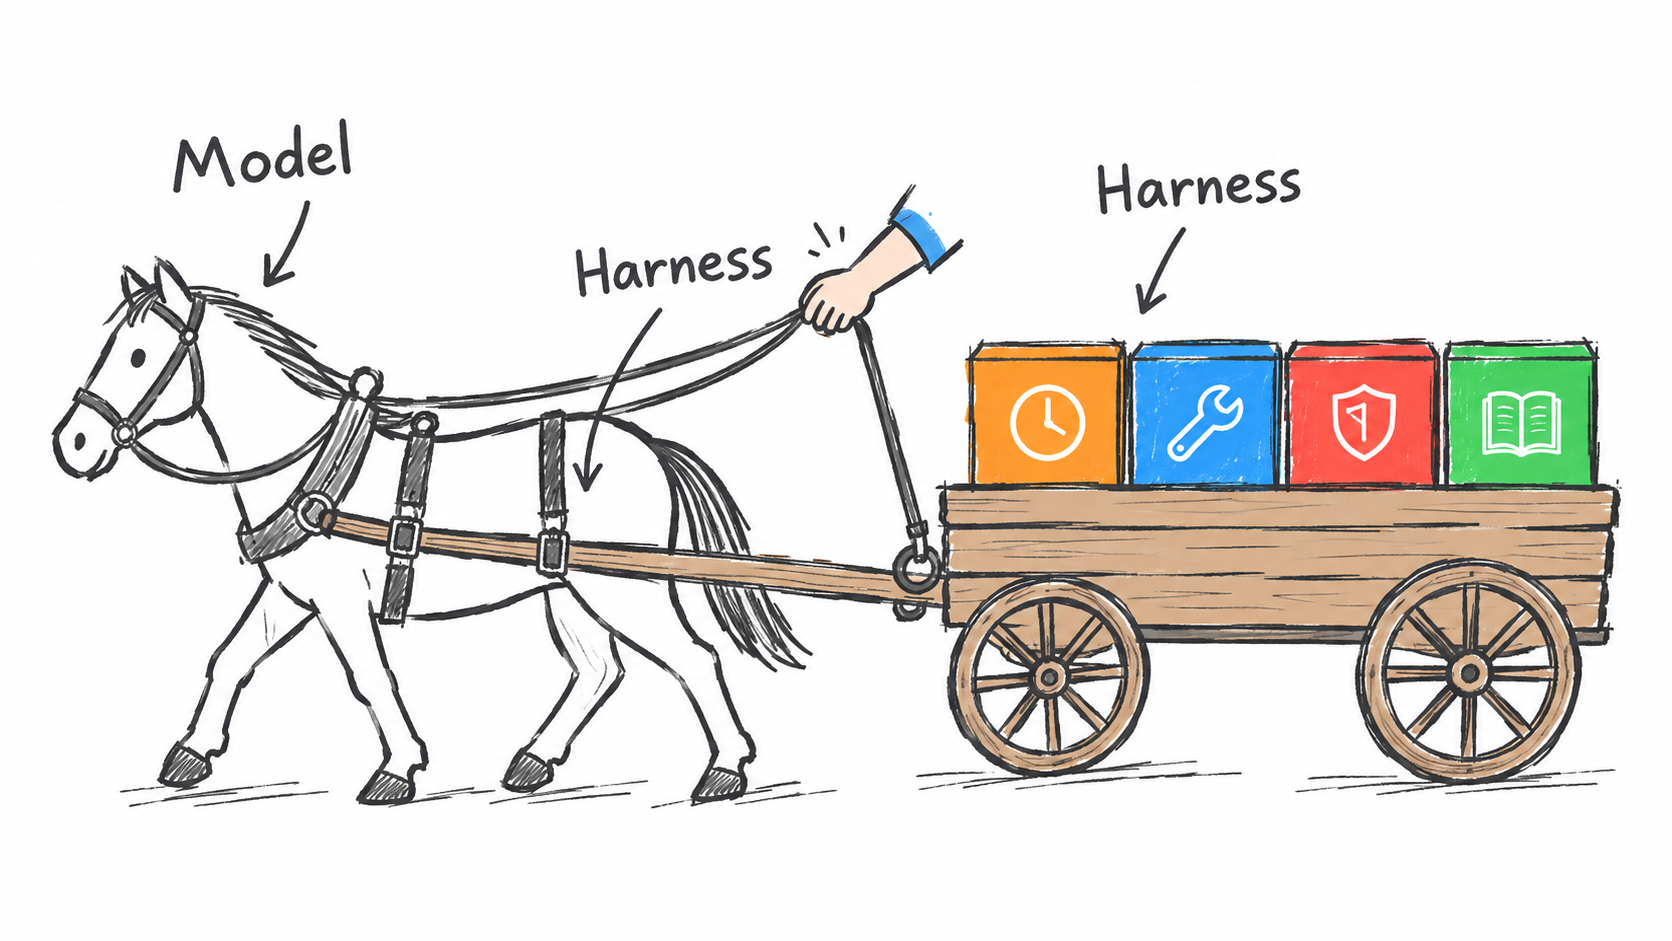
一个公式,其余全是注脚
理解这个领域,我觉得只需要一个公式:
Model 是模型,负责智能。Harness 直译是"马具",指模型之外的一切:循环、工具、上下文管理、权限、恢复机制。这个划分 2026 年初才被正式命名(harness engineering),但东西本身从第一天就存在。
公式为什么有用?因为 Harness 里的每个部件都能追溯到一个痛点,而所有痛点追到根上,是模型的两个先天事实:
- 模型无状态:每次调用都是失忆新人,所谓"记忆"只是当场重读的输入;
- 模型只会输出文本:它能描述怎么跑测试,但自己跑不了。
这两个事实分别生出前两条因果链:无状态生出上下文经济学,只会输出文本生出行动的可靠化。而前两条链一旦跑起来,又各自暴露新的问题,派生出后两条链:循环自主了,控制权就需要定价;会话用多了,教法就该沉淀。四条链的展开顺序,就是后文的小标题顺序。
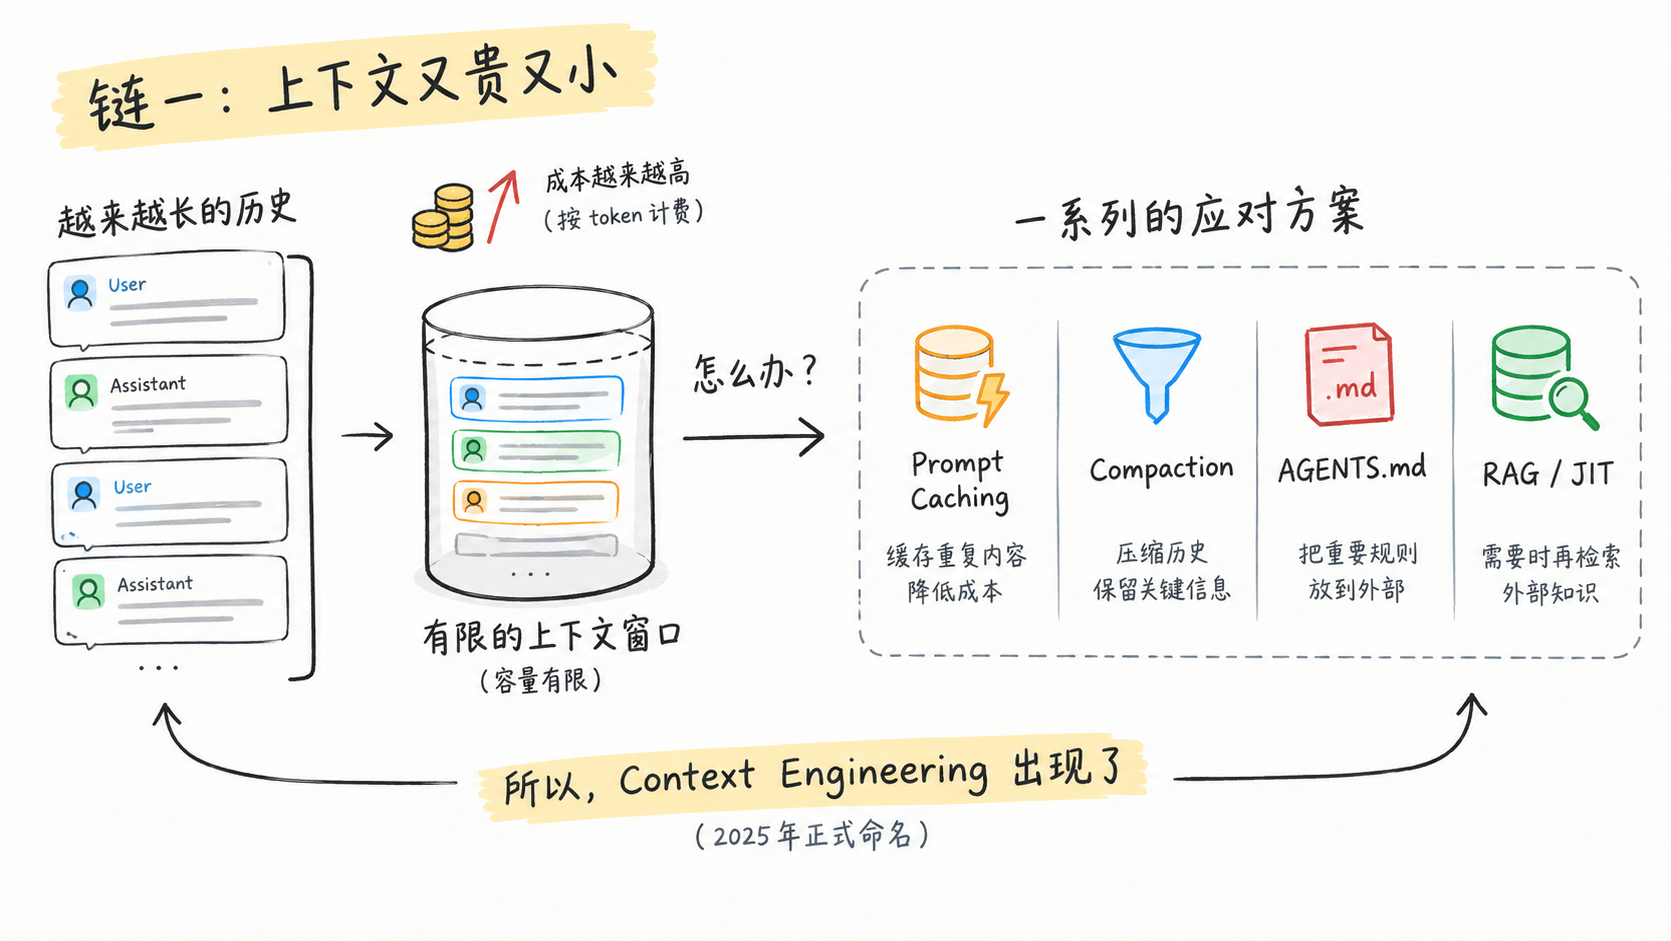
链一:上下文又贵又小
无状态意味着对话要连续,就得每次重发全部历史,按 token 计费。这同时撞上两堵墙:成本墙(历史越长越贵,于是有了 prompt caching)和容量墙(窗口有限,而且装得下不等于用得好)。
窗口要满了怎么办?压缩(compaction)。压缩丢信息怎么办?把重要的东西放到外面、要用再取。AGENTS.md、跨会话记忆、JIT 检索,都是这个思路的变体。2025 年,这一整套做法有了正式名字:context engineering。
IMPORTANT: 上下文是稀缺资源,又贵又小。这条链上的每个概念(caching、compaction、AGENTS.md、RAG 之争)都是这个约束的直接产物。
链二:文本要变成动作
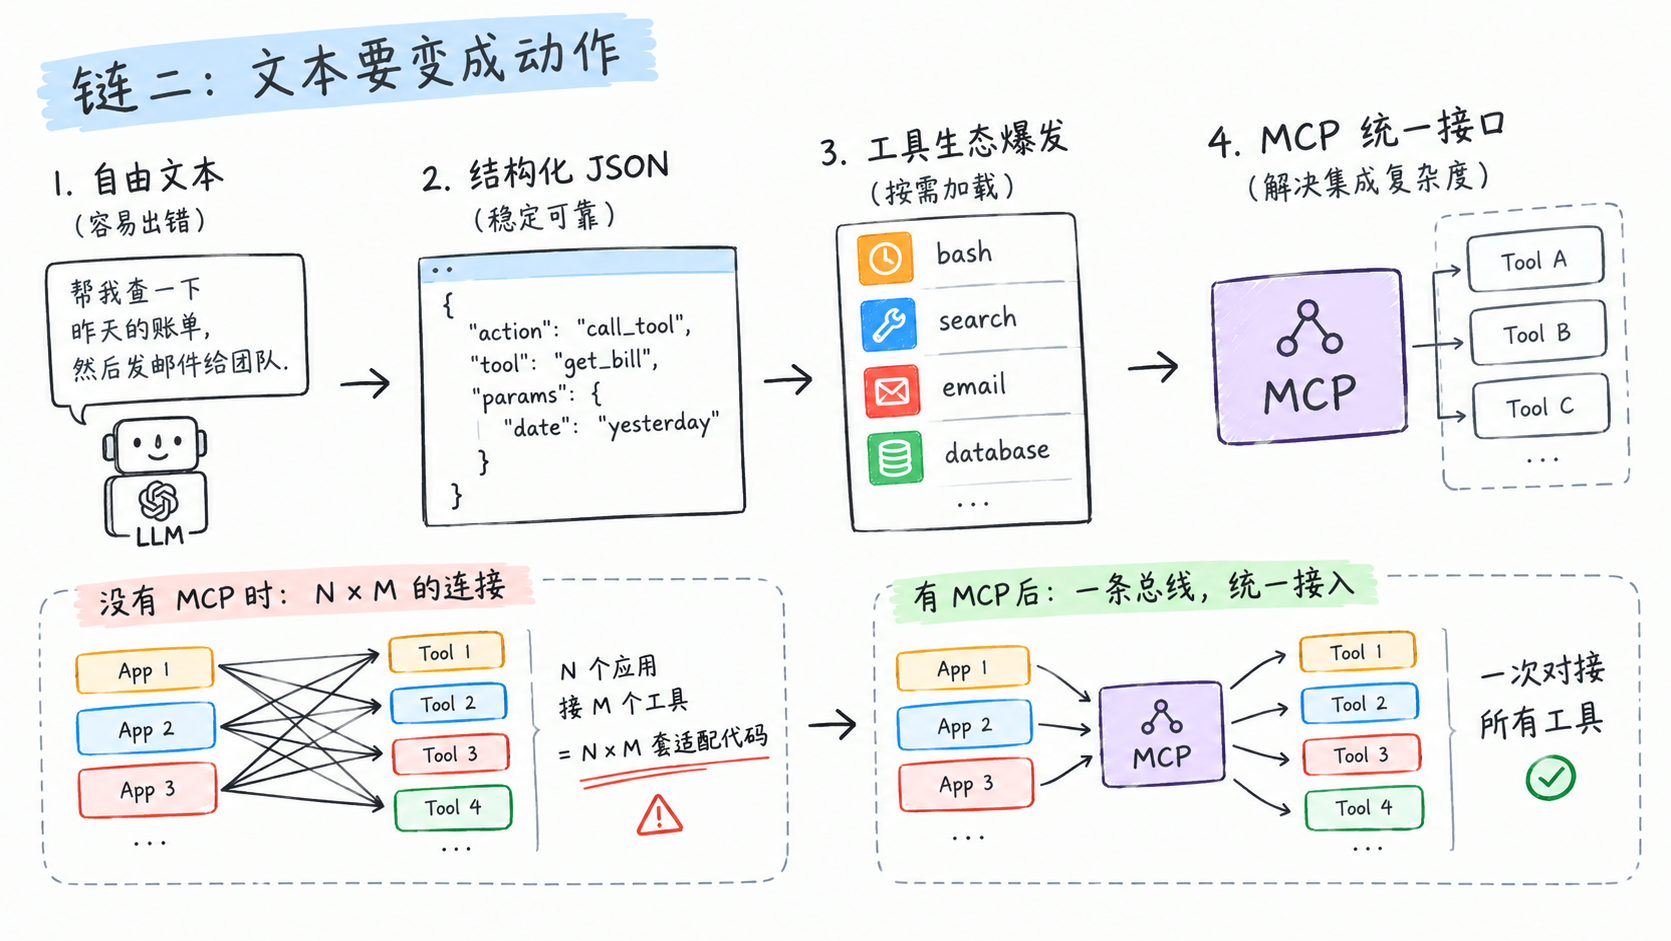
模型只会说话,想让它动手,学术界 2022 年给出了 ReAct:想一步、做一步、看结果再想。但 ReAct 的动作写在自由文本里,应用要靠解析器去提取,猜不中,动作就丢。2023 年 6 月 Function Calling 出来,动作变成 JSON 契约,这才稳定。
后面的都是连锁反应:动作结构化了,工具生态爆发,从 1 个 bash 到 100 多个;工具多了塞爆提示词,于是有了按需加载;各家接口不统一,N 个应用接 M 个工具要写 N×M 套适配代码,MCP 就是回应这个问题的。
链三:自主性需要约束
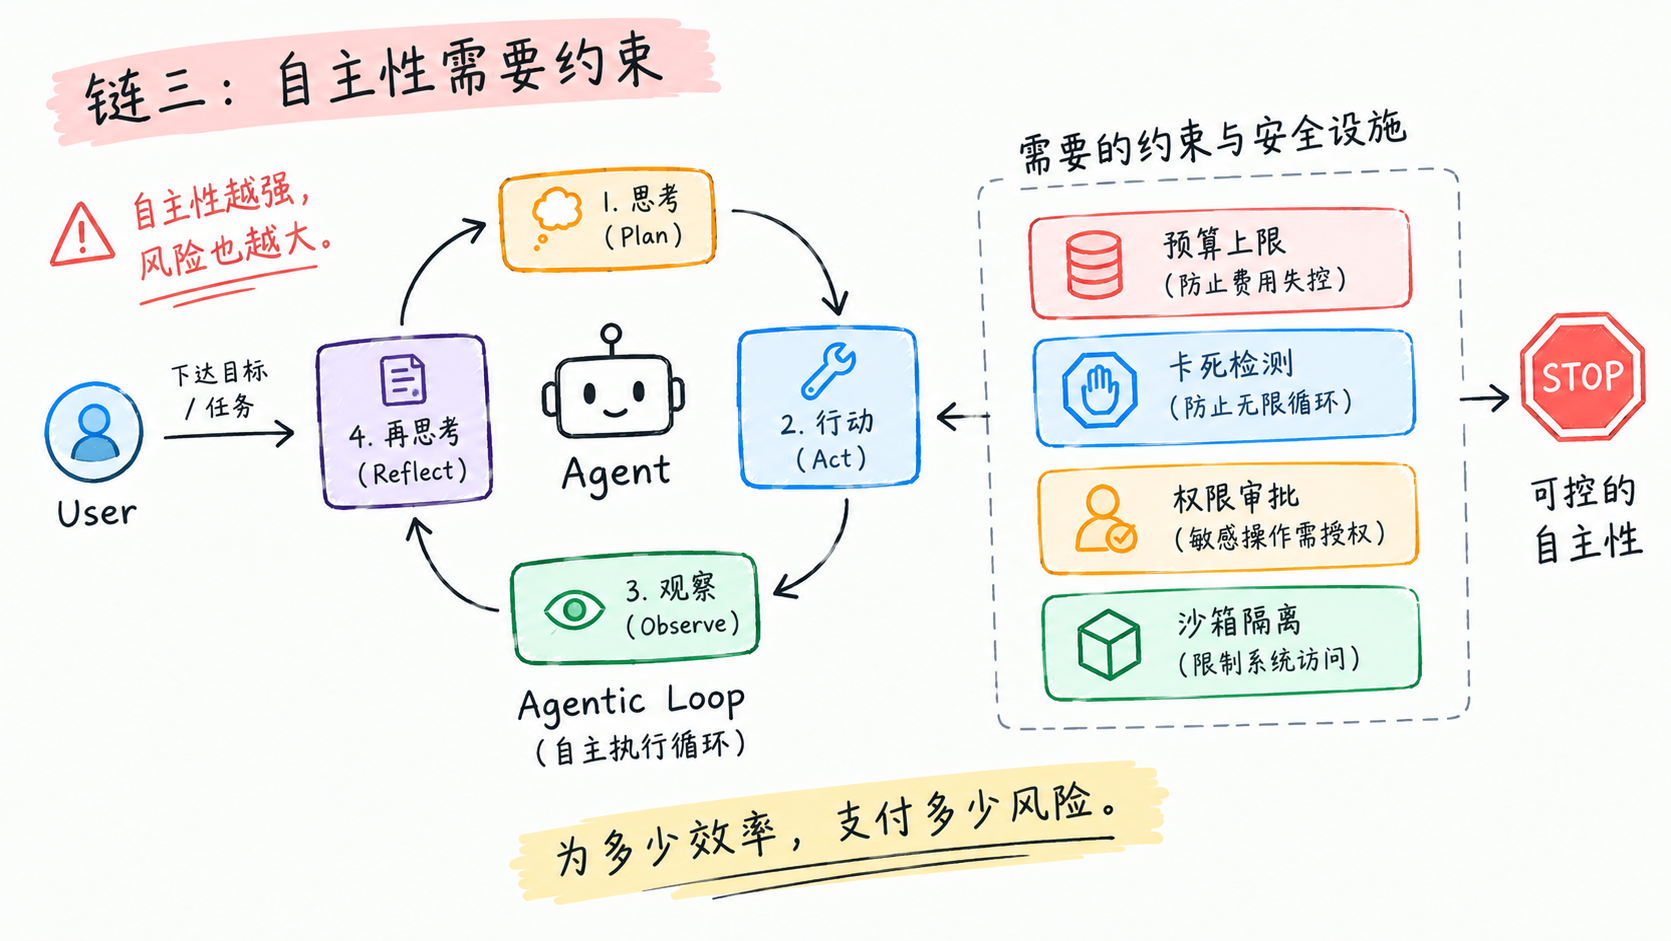
把每一步的决定权从人交给模型(agentic loop),效率上去了,风险也上去了。2023 年 3 月的 AutoGPT 用一场公开的失败证明了这一点:循环跑飞、费用失控、权限没有边界。
此后 harness 里的安全设施(预算上限、卡死检测、权限审批、沙箱),我理解都是在给自主性"定价":为多少效率,支付多少风险。
WARNING: "AutoGPT 的失败直接催生了这些安全设计"是我的推断,不是文献记载。系列写到这篇时会逐条论证,这里先说明。
链四:教过的东西应该沉淀
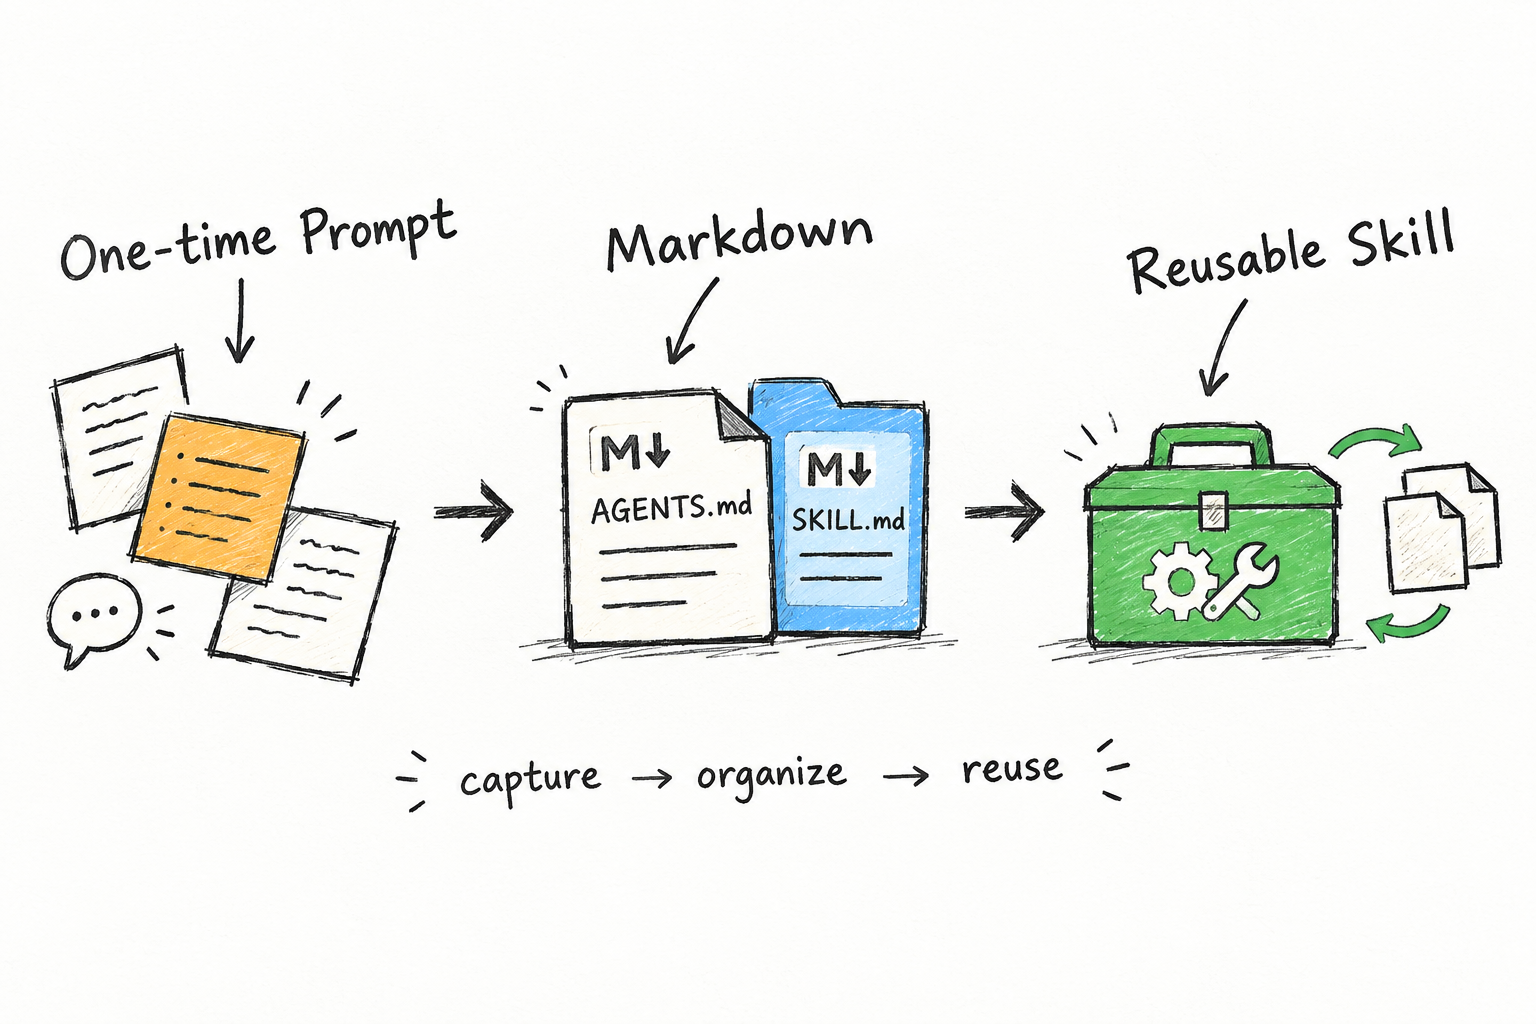
每个新会话都要重新教 agent 项目的规矩,这件事的浪费很明显。用户的自发行为是写 markdown 让模型读。Claude Code 的作者在访谈里说过,CLAUDE.md 就是这么来的。教法落成文件,文件标准化成 AGENTS.md,再打包成可分发的 skill,然后长出市场、信任分级,甚至出现了 agent 自己写的 skill。
一次性成本,就这样一路变成了可复用的资产。
拿 pi 验证,以及为什么选它
地图不能只在纸上成立,得找个实物对照。这个系列选的实物是 pi,先说为什么选它,有三条理由。
第一,它就在那篇论文解剖的 11 个系统里,是最小内核流派的代表。用它举例不是我个人偏爱,是有源码级背书的。第二,Claude Code 这类明星产品是闭源二进制,读者只能听我说;pi 核心极小、全开源,本文引用的每个机制读者都可以自己去仓库验证。第三,我天天在用它干活,能给出真实的配置,不是转述。
它的架构一句话能说清:核心只保留一个最小的模型循环,其余一切(工具、技能、权限、会话管理)都以扩展机制挂在这个循环上,用户的全部配置都在 ~/.pi/agent/ 目录下。
拿这个目录对四条链,一条对一个:
auth.json存各家模型的密钥,决定模型怎么接进来,对应链二;extensions/里我自己写过一个扩展,给 pi 加了一条查智谱余额的斜杠命令。能不动核心代码就长出新能力,靠的就是链四讲的扩展机制;extensions/security-allowlist.ts是个权限白名单,白名单目录随你读写,其他目录一律拦截,对应链三的权限层;sessions/里每个会话是一个本地 JSONL 文件,支持分支和压缩,对应链一。
四条链,一个配置目录,全部对上了。这个系列后面的文章会经常回到 pi:论文里的每个结论,我会尽量在自己天天用的工具里找到对应的东西,而不是只在纸面上转述。
写在最后
把四条链各压成一句话:
- 上下文经济学:上下文又贵又小,一切记忆概念都是它的账本;
- 行动可靠化:动作先是藏在文本里靠猜提取,结构化之后一路连锁到 MCP;
- 自主性约束:效率换来风险,安全设施是风险的价格标签;
- 沉淀标准化:教法从一次性咒语变成可流通资产。
它们不是孤岛:链二、三、四的一切产物(工具结果、审批记录、技能说明)最后都要占用上下文,而链一的全部概念(caching、compaction、检索)就是在管理这个池子。这也是 harness 最终成为一个整体的原因。
地图上每个节点我都做了出处核对,推断的地方会明确说明。下一篇从链一的开头讲起:(1)《无状态:一切的起点》。
参考资料
- Harness Engineering: Anatomy, Architecture, and Evolution of Coding Agents(四条链的源码级依据,11 个系统 400 万行)
- Lost in the Middle("装得下不等于用得好"的实验出处)
- Claude Code 作者 Boris Cherny 的 YC 访谈全文稿(CLAUDE.md 起源)
- pi(本系列的实物参照)